Когда начинаете новый проект, один из первых вопросов — как разделить систему. Запустить всё одним приложением или сразу разбить на независимые сервисы? Ответ сильно зависит от команды, сроков и объёма задачи.
В этой статье разберём три варианта: слойный монолит, модульный монолит и микросервисы. Слой и модуль — два разных способа резать код: слой режет по технической роли (контроллеры, сервисы, репозитории), модуль — по домену (заказы, оплата, каталог); вся разница между первыми двумя вариантами именно в этом. Для каждого — когда он уместен, в чём его слабые места и как понять, что пора меняться.
Выбирают не раз и навсегда: один и тот же чек-лист (он в конце статьи) на одном и том же продукте в разные годы даёт разные ответы.
Один продукт, один и тот же чек-лист: на старте набирается 1 балл — хватает слойного монолита, через год 3 балла — модульный, через три года 6 баллов — пора резать на сервисы. Архитектуру определяет сегодняшний балл, а не тот, что ожидают через три года.
Слойный монолит: один процесс, один деплой
Самый простой вариант. Всё приложение — один процесс: в нём и API, и бизнес-логика, и работа с базой данных. Деплоится одним файлом, отлаживается в одном месте.
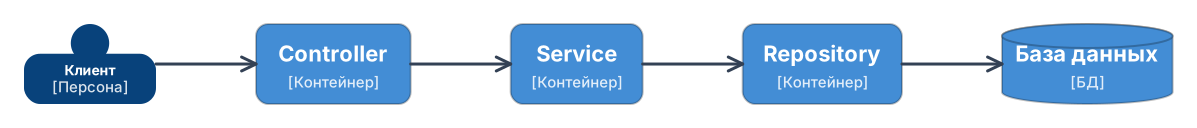
Такой подход хорошо работает, когда:
- Нагрузка небольшая и предсказуемая — до 250 запросов в секунду (это же число стоит в чек-листе в конце статьи).
- Команда маленькая — 1–3 разработчика.
- Нужно запустить продукт быстро.
- Домен узкий: сервис уведомлений, простой каталог товаров, прототип.
Что даёт: быстрая разработка, простая отладка, транзакции «из коробки», минимум инфраструктуры.
Где подведёт: когда кодовая база разрастается без чётких границ, разные части системы начинают мешать друг другу: поправили расчёт скидки — сломались уведомления, потому что обе части читают один и тот же класс заказа. Код, где всё зависит от всего, называют «большой комок грязи» (Big Ball of Mud) — это главный риск монолита без дисциплины.
Сигналы, что пора что-то менять:
- Разные части системы меняются с разной скоростью, а релизы всё равно нужно согласовывать.
- Команда выросла до 2+ независимых групп.
- Кодовая база перевалила за 50 000 строк и разобраться в ней становится сложно.
Модульный монолит: границы внутри одного приложения
Промежуточный вариант между монолитом и микросервисами. Физически это всё ещё один процесс и один деплой — но внутри чётко выделены модули с отдельными зонами ответственности. Каждый модуль работает со своей частью данных и общается с другими через события или явные интерфейсы, а не через прямые вызовы чужого кода.
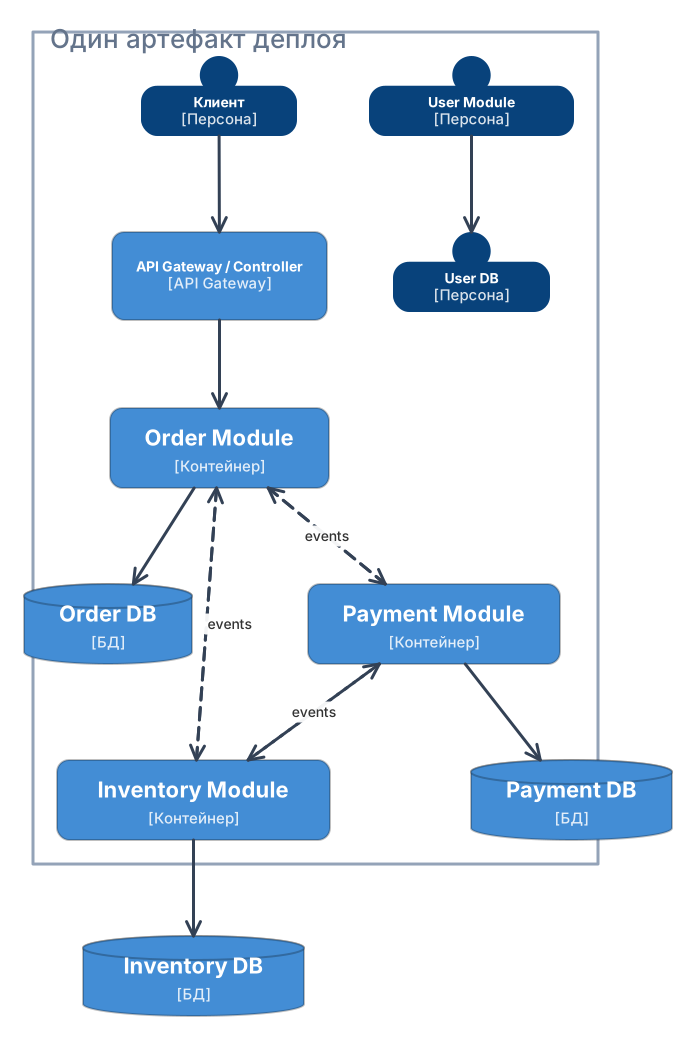
Хорошо подходит, когда:
- Продукт потенциально большой, но нужен быстрый старт.
- Команда 5–7 человек, ожидается рост.
- Хочется сохранить возможность позже разбить на сервисы без переписывания всего с нуля.
Что даёт: нет сетевых задержек (всё в одном процессе), транзакции проще, чем в микросервисах, а структура уже готова к росту.
Где подведёт: границы между модулями легко нарушить — особенно когда торопятся. Чужая модель начинает просачиваться к соседу через «shared»-классы. Всё это надо отслеживать на ревью вручную. Ещё одна проблема: большой монолит тяжелее в IDE и при сборке.
Сигналы к разбивке на сервисы:
- Конкретный модуль стал узким местом по нагрузке и его нужно масштабировать отдельно.
- Команды разошлись и хотят деплоить независимо.
- Нужно отдать отдельный модуль сторонней команде.
- Кодовая база перевалила за 200 000 строк, команд стало три и больше.
Микросервисы: независимые сервисы с отдельными базами
Каждый сервис — отдельный процесс со своей базой данных. Сервисы общаются через HTTP или очередь сообщений. Деплоятся, масштабируются и падают независимо друг от друга.
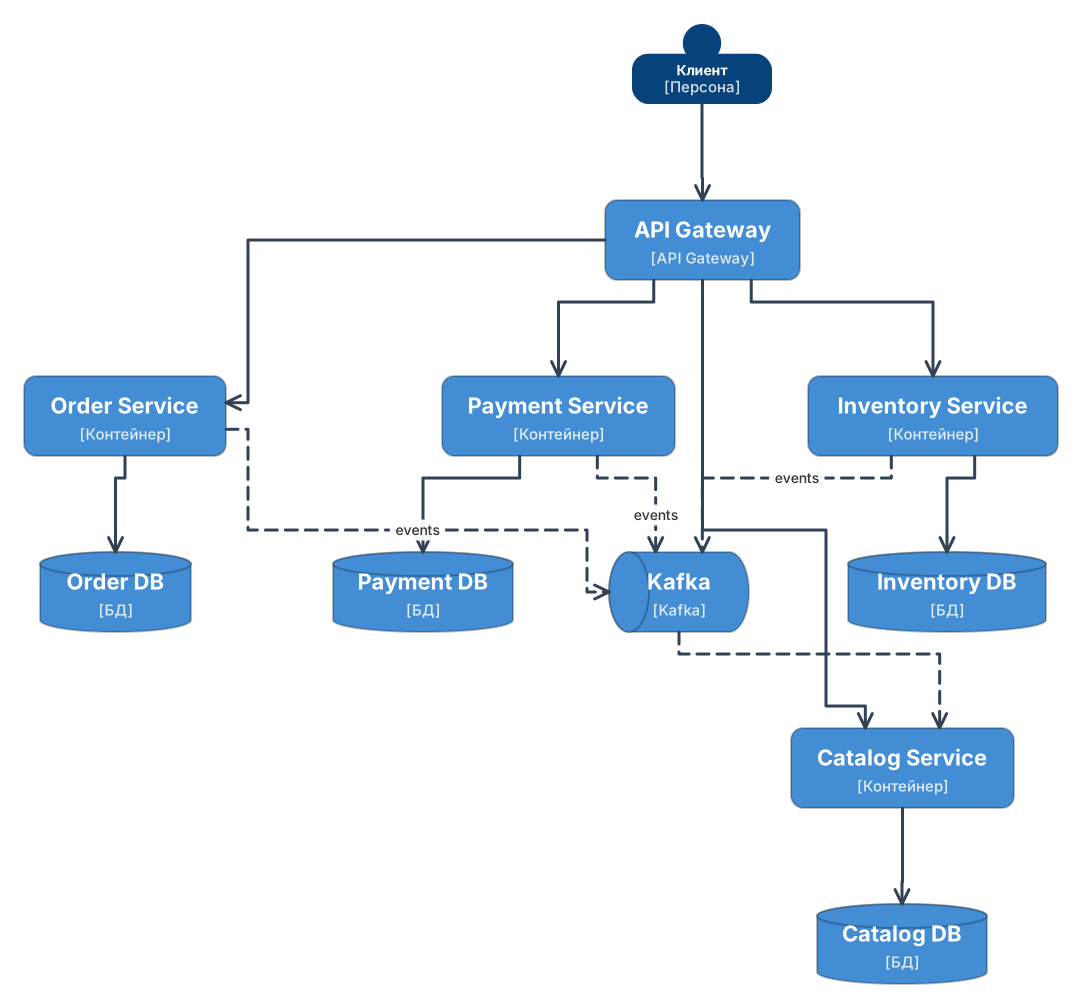
Оправдано, когда:
- Проект крупный, сроки не поджимают, есть сильная команда и выстроенный DevOps.
- Разные части системы развиваются с разными требованиями к нагрузке и надёжности.
- Работают несколько независимых команд.
- Нагрузка высокая и неравномерная — одни сервисы нужно масштабировать, другие нет.
Что даёт: независимые релизы и масштабирование, разные технологии в разных сервисах. Сбой одного сервиса можно удержать внутри него — но само по себе это не получается: если оформление заказа синхронно ждёт ответа от сервиса писем, упавшие письма отменят заказ. Изоляция появляется только там, где связь асинхронная или есть запасной путь.
Где подведёт: сетевые задержки; одной транзакции на всю операцию больше нет — вместо неё цепочка отдельных, каждая в своей базе, а откат делают вручную встречными действиями (Saga); сложная трассировка запросов, высокие требования к инфраструктуре (gateway, контрактные тесты, наблюдаемость). Это самый дорогой вариант по затратам на разработку и поддержку.
Когда точно не стоит:
- Маленькая команда или нет опыта с такой архитектурой.
- Домен ещё не стабилизировался — границы сервисов придётся постоянно переделывать.
- Срок запуска «вчера».
Подробнее о том, что нужно выстроить вокруг микросервисов: структурные паттерны и распределённые паттерны.
Разделить сервисы — значит разрезать базу
Про микросервисы говорят как про способ разложить код, а разложить приходится данные. Отдельная база у каждого сервиса — это не деталь из списка, а само содержание разбивки: пока база общая, сервисов нет, сколько бы процессов ни было запущено.
Общая база — это не микросервисы. Два сервиса пишут в одну таблицу — и любой из них может сломать другого изменением схемы; миграцию нельзя выкатить, не согласовав с соседом; нагрузка одного упирается в тот же диск, что у другого; и никакой независимости релизов нет, потому что схема — это тоже контракт. Промежуточный вариант «общая база, но каждый пишет только в свои таблицы» уже лучше, но остаётся ловушкой: соседу слишком легко прочитать вашу таблицу напрямую, и однажды кто-то это сделает — обычно в отчёте, который никто не считает кодом.
Что делать с соединениями через границу. Запрос «покажи заказы этого покупателя с названиями товаров» раньше был одним JOIN, а теперь данные в двух базах. Работающих ответов три, и выбирают по частоте запроса.
- Сборка на стороне вызывающего. Сервис заказов отдаёт список с идентификаторами товаров, вызывающий (шлюз или интерфейс для клиента) добирает названия из каталога одним запросом на список. Просто, но каждый экран стоит двух вызовов, а недоступность каталога портит экран заказов.
- Своя копия нужных полей. Сервис заказов хранит у себя название и цену товара на момент покупки — и это не денормализация ради скорости, а правильная модель: в чеке должна остаться та цена, по которой купили, даже если в каталоге она изменилась. Копия приезжает событием и живёт своей жизнью.
- Отдельная модель для чтения. Экран собирает данные трёх сервисов, и для него строят читающую модель: события наполняют отдельную таблицу, запрос идёт к ней. Это уже заметная сложность — задержка, пересборка, расхождения, — и берут её, когда первые два не справляются.
Что делать с отчётами. Отчёт «выручка по категориям за квартал» хочет данные всех сервисов сразу, и это нормальная потребность, которую нельзя закрывать прямым доступом к чужим базам. Отчётность выносят в отдельное хранилище: данные сервисов попадают туда потоком изменений или регулярной выгрузкой, а аналитики работают там. Тогда тяжёлый запрос не тормозит боевую базу, а схема сервиса остаётся свободной.
И главное про транзакции. Транзакция базы данных не переходит границу сервиса: «списать деньги и создать заказ» в одном коммите больше не получится. Вместо этого — последовательность шагов с отменой, идемпотентные обработчики и отдельное состояние «в процессе». Это самый дорогой пункт всей разбивки, и разбирают его распределённые паттерны и статья про согласованность.
Практическое следствие для выбора: если данные вашего домена сильно связаны и почти каждый запрос требует трёх сущностей из разных углов, разбивка обойдётся дороже, чем обещает чек-лист. Это аргумент за модульный монолит, где границы есть, а транзакция остаётся одна.
Закон Конвея: почему в чек-листе вопросы про команды
Два пункта чек-листа спрашивают про число команд и независимые релизы, и без одного наблюдения они выглядят произвольными. Наблюдение называется законом Конвея и звучит так: система повторяет структуру общения тех, кто её делает. Не «должна повторять» — повторяет, независимо от планов на схеме.
Механика простая. Договориться внутри команды дешевле, чем между командами: спросил соседа за столом, поправил вместе, выкатил. Между командами нужны согласование, очередь задач, ожидание релиза. Поэтому код внутри зоны одной команды становится связным и плотным, а на границах между командами появляются интерфейсы — просто потому, что иначе работать больно.
Отсюда два вывода, которые видны в реальных проектах.
Одна команда не получит настоящих микросервисов. Пять сервисов у четырёх человек означают, что все меняют всё, каждый выкат групповой, а границы существуют только на схеме. Работает то же, что и всегда: внутри своей зоны команда правит сквозь границы, потому что ей так удобнее. Это не недостаток дисциплины, это экономика общения.
Границы сервисов лучше проводить по командам, а не по существительным. Обратный ход тоже работает — его называют обратным манёвром Конвея: сначала организуют команды так, как хотят видеть систему, и тогда архитектура получается сама. Практически это значит, что вопрос «сколько у нас команд и за что каждая отвечает» надо задать до того, как рисовать сервисы, иначе через год сервисы всё равно перестроятся под людей, но через боль.
И третий, неприятный: выделенная команда сопровождения общей библиотеки или общей базы — это гарантированная точка синхронизации. Всё, что проходит через неё, перестаёт быть независимым, сколько сервисов ни нарежь.
Цена одного сервиса
«Микросервисы — самый дорогой вариант» — фраза, за которой обычно нет ничего конкретного. Вот из чего складывается цена, и считать её надо на каждый сервис, а не на систему.
Разовые затраты на появление сервиса: репозиторий с настройками, конвейер сборки, описание выкладки в оба контура, своя база с миграциями и копиями, секреты и доступы, панель метрик и набор сигналов, подключение к сбору логов и трассировке, регистрация в реестре сервисов и в каталоге дежурств, проверки живости и готовности. У команды, где всё это уже налажено шаблоном, — день-два; там, где шаблона нет, — недели, и первый сервис всегда дороже остальных.
Постоянные затраты, о которых вспоминают позже: обновление зависимостей и базового образа в каждом сервисе (десять сервисов — десять обновлений), сертификаты и доступы, дежурство и разбор сигналов, поддержка контрактов при каждом изменении (см. раздел про независимые релизы ниже), отладка, которая теперь идёт по трассировке, а не по стеку вызовов. Добавляется и время людей на согласование: каждая межсервисная правка — это разговор двух команд.
Вот ориентир, который помогает на развилке. Один сервис в системе, где инфраструктура готова, стоит примерно как небольшая функциональность: день на обвязку, потом несколько часов в месяц на обслуживание. Десять сервисов — это уже полноценная работа по эксплуатации, которую кто-то должен делать вместо разработки функций. Если в команде нет человека, готового взять эти часы, разбивка съест их у всех сразу, и это будет выглядеть как «стало медленнее, чем в монолите» — потому что так и есть.
Обратная сторона, которую тоже стоит назвать: у монолита своя цена, и она растёт нелинейно. Полчаса на сборку и тесты, выкат раз в две недели с окном, потому что откатить рискованно, конфликт трёх команд в одном файле конфигурации, и масштабирование целиком ради одного тяжёлого места. Правильный вопрос не «что дороже», а «что дороже при нашем размере — обслуживать десять конвейеров или ждать общий релиз».
Как выбрать: простой чек-лист
За каждое «Да» — один балл:
| Вопрос | Да |
|---|---|
| Сроки не поджимают? | ☐ |
| Нагрузка высокая (>250 RPS) или пики критичны? | ☐ |
| Доменов пять и больше, они меняются независимо? | ☐ |
| Нужны независимые релизы у разных команд? | ☐ |
| Жёсткие требования к доступности (SLA 99.95%+ или p95 < 100 мс)? | ☐ |
| Система будет жить и развиваться несколько лет? | ☐ |
Итого:
- 0–1 балл → слойный монолит
- 2–3 балла → модульный монолит
- 4–6 баллов → микросервисы
Числа в вопросах — ориентиры, а не пороги: 250 запросов в секунду и 99,95 % — уровень, на котором один экземпляр монолита с одной базой ещё держится без специальных мер, а выше части системы приходится масштабировать и изолировать по отдельности; пять доменов — когда одного общего релиза командам уже мало.
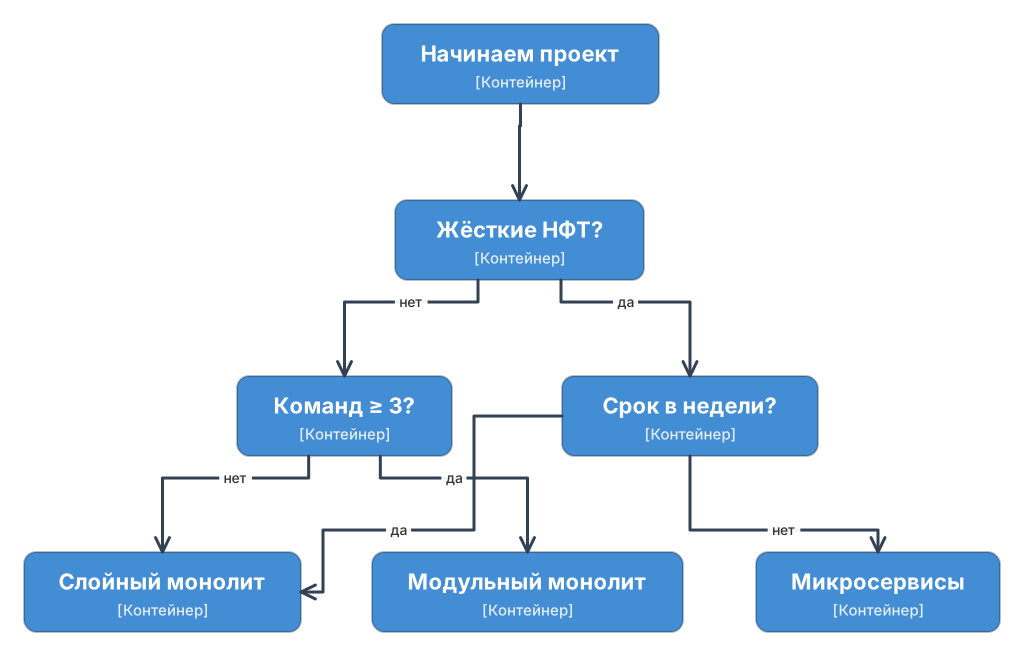
Не выбирайте микросервисы потому что «так делают все крупные компании»: они пришли к этому после того, как монолит перестал справляться. Если домен вырастет, всегда можно мигрировать через паттерн Strangler Fig: постепенно вырезать части монолита в отдельные сервисы, не останавливая систему.
Про этот переезд стоит сказать чуть больше, потому что «постепенно вырезать» скрывает всю работу. Порядок такой. Перед монолитом ставят шлюз, через который уже идёт весь трафик, — иначе переключать некуда. Первым выносят модуль, у которого своя нагрузка или свой темп изменений и мало связей с остальными: чаще это уведомления, поиск, выгрузки, а не «самое главное». Новый сервис сначала работает в тени: получает копию запросов, пишет свой ответ в лог, и его ответы сравнивают с ответами монолита, пока расхождения не исчезнут. Потом шлюз переводит на него сначала долю запросов, потом все. Данные при этом какое-то время живут в двух местах, и на это время назначают один источник правды: пишем в монолит, поток изменений наполняет базу сервиса (или наоборот), но не пишем в оба сразу. И обязательный последний шаг, который часто забывают: удалить код из монолита. Пока он там лежит, кто-нибудь его позовёт, и переезд не закончится никогда.
Подробный разбор этого пути — с шлюзом, теневым сравнением и планом по данным — в статье про структурные паттерны микросервисов.
Переезд по Strangler Fig по шагам: смотрите на последнюю строку, пока старый код не удалён из монолита, переезд не закончен.
Обратный ход: склеить сервисы
Статьи про архитектуру обычно описывают движение в одну сторону: монолит вырос, разбиваем. На практике обратная операция не редкость и не признак поражения — это нормальная правка, если разбивка оказалась мельче, чем нужно.
Признаки, что склеивать пора, те же, что у распределённого монолита: два сервиса всегда выкатываются вместе, любая правка задевает оба, между ними синхронная цепочка на каждый запрос, и у них общие данные, которые приходится держать согласованными кодом. Добавьте к этому простой вопрос: кто-нибудь вообще выкатывал их по отдельности за последние три месяца?
Как это делают.
- Проверить, что это не границы, а связанность. Если сервисы меняются вместе, потому что граница прошла по слоям, склейка — правильный ответ. Если потому что задача крупная и один раз затронула оба — нет, это обычная работа.
- Объединить код, оставив модули. Два сервиса становятся двумя модулями в одном приложении с тем же разделением пакетов и с прежними API внутри — то есть получается модульный монолит, а не свалка. Так склейка обратима.
- Объединить базы по одной таблице за раз. Сначала одно приложение работает с двумя базами (это нормально и часто надолго), потом таблицы переносят в одну, начиная с тех, которые участвуют в общих транзакциях. Ради них склейка и делается: транзакция вместо саги — главный приз.
- Убрать сетевые вызовы последними. Пока вызов идёт через HTTP внутри одного процесса, всё работает; заменяют его на прямой вызов метода после того, как код уже вместе. Так на каждом шаге система остаётся живой.
- Снять лишнюю обвязку. Один конвейер вместо двух, одна панель, один сигнал, одно дежурство. Это та самая экономия, ради которой всё и делалось.
И правило, которое экономит много спорных встреч: решение «склеить» принимают по журналу выкатов и инцидентов, а не по ощущению. Если больше половины выкатов — групповые, это не мнение, а факт.
Глубже: по чему резать: границы сервисарасширенное
Решение «делаем сервисы» сразу упирается в вопрос, которого в чек-листе нет: где проходит граница. Резать по слоям (сервис контроллеров, сервис базы) или по существительным из базы (сервис таблицы users) это самые частые ошибки, и обе дают сервисы, которые не могут сделать ничего полезного без трёх соседей.
Критерий один: сервис владеет своими данными и своими решениями, и большая часть изменений укладывается внутрь него. Отсюда четыре проверки на границу. Изменения приходят вместе. Если правка правила «скидка для постоянных клиентов» требует выката трёх сервисов, граница прошла по живому; если одного, она на месте. Данные принадлежат одному. У каждой таблицы ровно один сервис, который в неё пишет, остальные получают копии через события или спрашивают по API; таблица, в которую пишут двое, это склеенные сервисы. Язык внутри один. Слово «заказ» в оформлении означает корзину с адресом, на складе список позиций для сборки, в бухгалтерии документ с суммой; это три разных модели, и это три кандидата на границу. Так работает ограниченный контекст из DDD, о котором говорит статья про стратегические паттерны, и это лучший из известных инструментов резки. Команда одна. Сервис, за который отвечают две команды, или команда, у которой шесть сервисов, это сигнал: границы сервисов повторяют границы команд, хотят они того или нет.
Размер при этом вторичен: «микро» относится к области ответственности, а не к числу строк. Сервис заказов на пятьдесят тысяч строк с одной базой и одной командой это нормально; сервис «валидация адреса» на триста строк, который зовут все и который ломает всех при выкате, нет.
Практический порядок: сначала границы внутри монолита, модулями с явным API и запретом на прямой доступ к чужим таблицам (о модульном монолите выше); полгода наблюдать, какие модули меняются вместе и какие данные пересекаются; и выносить первым тот модуль, у которого своя нагрузка или свой темп изменений, а не тот, который проще всего отделить.
Глубже: распределённый монолит: как понять, что не получилосьрасширенное
Сервисов десять, репозиториев десять, а выкатывать приходится все сразу и в определённом порядке. Это распределённый монолит: все минусы сервисов (сеть, частичные отказы, десять конвейеров) без единственного плюса, независимых релизов. Самый частый исход неудачной разбивки, и его полезно уметь распознать по признакам, пока не поздно.
Признаки. Общая база или общая библиотека с доменными классами, которую обновляют все сразу: изменение сущности требует пересборки всех. Синхронная цепочка на каждый запрос пользователя: шлюз зовёт A, A зовёт B, B зовёт C, и падение любого это падение всех, а задержка складывается. Релиз-поезд: «выкатываем в четверг всё вместе», потому что порознь не работает. Тесты, которые поднимают всю систему, потому что сервис по отдельности проверить нельзя. Один сервис не может стартовать без другого. Изменение поля в ответе A ломает B в тот же день.
Причина почти всегда в границах и в контрактах: границы прошли по слоям или по таблицам (см. раздел выше), а контракты меняются без совместимости (см. раздел ниже). Обратный путь дешевле, чем кажется: сервисы, которые всегда меняются вместе, честно склеивают обратно в один, а общую библиотеку доменных классов заменяют контрактами с версиями. Критерий «получилось или нет» простой и проверяемый по журналу выкатов: если за последний месяц больше половины выкатов затронули один сервис, разбивка работает; если большинство выкатов групповые, у вас распределённый монолит, и следующий шаг это не одиннадцатый сервис.
Глубже: независимые релизы: совместимость контрактов и контрактные тестырасширенное
Обещание микросервисов, независимые релизы, держится на одном условии: сервис можно обновить, не обновляя тех, кто его зовёт. У сервиса пять потребителей, обновляются они порознь и не в вашем темпе, и любое изменение контракта проходит через это условие.
Расширяющее против ломающего. Добавить необязательное поле в ответ, новый необязательный параметр, новый эндпоинт, новое значение в ответе, которое старые клиенты игнорируют: расширяющее, выкатывается без согласования. Убрать или переименовать поле, сделать необязательное обязательным, поменять тип или смысл, сузить перечисление: ломающее. Ломающее изменение делают через расширение и сжатие: добавить новое рядом со старым, дождаться, пока последний потребитель переедет (это видно по метрике использования старого поля), убрать старое. Три выката вместо одного, и это цена независимости. Как это выглядит для REST, разбирает статья про версионирование в разделе REST, для событий статья про паттерны через AMQP.
Терпимый читатель. Потребитель обязан игнорировать незнакомые поля и не падать на новых значениях; сервис, который отвергает неизвестное в ответе соседа, делает любое расширение ломающим для себя. Это правило про десериализацию ответов и событий, а не команд, которые вы принимаете.
Контрактные тесты. Ревью не ловит ломающих изменений, ловит сборка. Сравнение спецификации с прошлой версией (oasdiff breaking, buf breaking) падает на ломающем изменении; контрактные тесты со стороны потребителя (Pact) описывают, что каждый потребитель на самом деле читает, и сборка поставщика проверяет все эти ожидания до выката. С ними «удалили поле, которым никто не пользуется» становится утверждением, которое проверено, а не предположением. Подробно в статье про API-first.
Когда потребителей пять и они в разных командах, это единственный способ выкатываться независимо. Когда потребитель один и он ваш, достаточно правила расширения и сжатия и одного теста на схему.
Коротко
- Слойный монолит — простой старт, минимум инфраструктуры; хорошо для маленьких команд и узкого домена. Модульный монолит — границы внутри одного приложения; позволяет расти и потом безболезненно разбиться на сервисы.
- Микросервисы — независимые процессы и базы; оправданы при высокой нагрузке, нескольких командах и зрелой инфраструктуре.
- Главный риск монолита — размытые границы (Big Ball of Mud). Главный риск микросервисов — сложность, которую команда не готова нести. Не выбирайте архитектуру под будущий рост, которого может не быть. Начинайте с простого и мигрируйте, когда монолит начнёт мешать.
- Границы сервиса проходят там, где изменения приходят вместе, данные принадлежат одному, язык один и команда одна; размер вторичен, начинают с модулей внутри монолита.
- Распределённый монолит узнают по общей базе или библиотеке доменных классов, синхронным цепочкам и релиз-поезду; проверка по журналу: большинство выкатов одиночные или групповые.
- Независимые релизы держатся на совместимости: расширяющие изменения свободно, ломающие через расширение и сжатие, терпимый читатель, сравнение спецификаций и контрактные тесты в сборке.
- Разбивка — это разрезание базы: общая база отменяет независимость релизов, соединения через границу заменяют сборкой на вызывающем, своей копией нужных полей или моделью для чтения, а отчётность выносят в отдельное хранилище. Транзакция не переходит границу сервиса: вместо одного коммита — шаги с отменой и идемпотентные обработчики, и это самая дорогая часть переезда.
- Закон Конвея: система повторяет структуру общения команд, поэтому одна команда не получит настоящих микросервисов, а границы сервисов стоит проводить по командам.
- Цена считается на сервис: разово день-два обвязки при готовом шаблоне, постоянно — обновления, дежурство и поддержка контрактов; десять сервисов это уже отдельная работа по эксплуатации.
- Склеить сервисы обратно — нормальная операция: код объединяют модулями, базы по одной таблице, сетевые вызовы убирают последними, а решение принимают по журналу выкатов.
Что пощупать
Цену одного сервиса можно посчитать по infra/compose.yaml практикума remodov/marketplace-system: восемь сервисов маркетплейса, у каждого своя база, плюс Kafka, Redis, Mongo, Elasticsearch, MinIO и Keycloak. И там же видно, что начинать с этого не нужно: первые шесть шагов живут в одном стартовом сервисе с одной базой.
Код: infra/compose.yaml, services.
Сделаем сами
Ветка step-07-usecase-and-handler — сравнение двух каталогов и перенос смены цены во взрослый.
На Go: ветка step-07-adult-catalog — те же два каталога, catalog-starter и catalog, и тот же перенос смены цены по слоям.
Что почитать дальше
- Структурные паттерны микросервисов — обвязка, без которой микросервисы не живут.
- Распределённые паттерны — Saga, Outbox, идемпотентность.
- Паттерны отказоустойчивости — Retry, Circuit Breaker, Bulkhead.
- DDD: стратегические паттерны — Bounded Context как основа модульного разделения.