Когда сервисов в системе становится больше одного, им нужно обмениваться событиями. Kafka — один из самых распространённых инструментов для этого. Разберём с нуля: зачем она нужна, как работает и где подводные камни.
Проблема: сервисы связаны напрямую
Представьте: пользователь оформляет заказ. OrderService должен уведомить PaymentService, InventoryService и NotificationService. Самый простой вариант — HTTP-вызовы напрямую.
Но у этого подхода есть проблема: если PaymentService недоступен, OrderService тоже не может завершить работу. Один падающий сервис тянет за собой другие. Это называют синхронной связностью — сервисы зависят друг от друга в реальном времени.
Kafka решает это иначе. Это распределённый лог сообщений: OrderService записывает событие «заказ создан», а все заинтересованные сервисы читают его самостоятельно — каждый в своём темпе. Если NotificationService временно упал, он просто догонит пропущенные события после перезапуска.
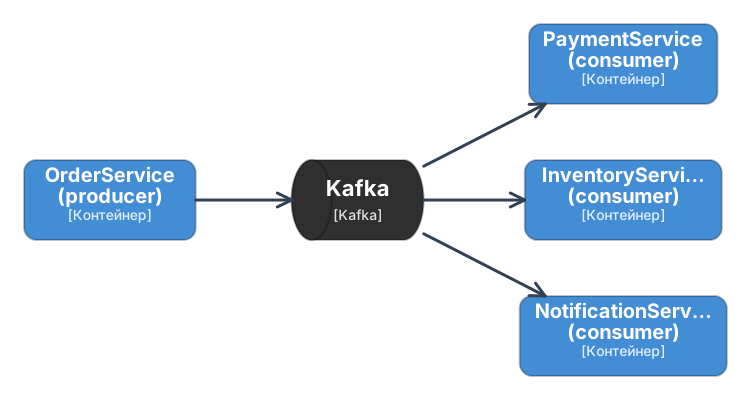
OrderService не знает, кто его читает. Новые потребители добавляются без изменений в коде отправителя.
Топик, партиция, offsetспросят на собеседовании
Топик
Топик — это именованный лог сообщений. Сервисы пишут в топики и читают из них. Имя отражает домен: order-events, payment-events, inventory-changes.
Каждое сообщение — пара (ключ, значение) плюс метаданные (timestamp, headers, offset):
ключ:    "order-12345"
значение: {"type":"OrderCreated","orderId":"12345","total":1500.00}
Партиция
Топик физически разбит на партиции. Партиция — это упорядоченный неизменяемый лог: сообщения только добавляются в конец, никогда не меняются и не удаляются (до истечения срока хранения).
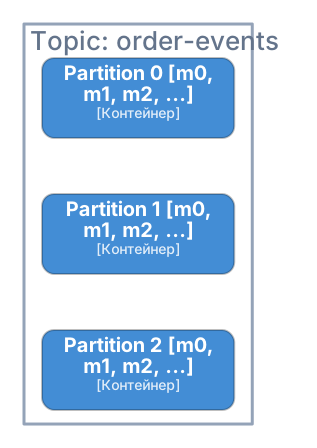
Зачем партиции:
- Параллелизм — разные потребители читают разные партиции одновременно.
- Масштабирование — партиции распределяются по разным брокерам (серверам).
- Порядок — гарантируется только внутри одной партиции.
Offset
Каждое сообщение в партиции имеет порядковый номер — offset. Потребитель запоминает, до какого offset он дочитал, и продолжает именно оттуда. Это позволяет перечитать старые сообщения или начать с начала.
Отправитель и потребитель
Producer — клиент, который пишет в Kafka. Consumer — клиент, который читает из Kafka.
# Отправитель
class OrderEventPublisher:
    def __init__(self, producer: AIOKafkaProducer):
        self._producer = producer

    async def publish(self, event: OrderCreatedEvent) -> None:
        await self._producer.send_and_wait(
            "order-events",
            key=event.order_id.encode(),
            value=to_json(event).encode(),
        )

# Потребитель
async def payment_consumer() -> None:
    consumer = AIOKafkaConsumer("order-events", group_id="payment-service")
    await consumer.start()
    try:
        async for record in consumer:
            event = from_json(record.value, OrderCreatedEvent)
            # обработка...
    finally:
        await consumer.stop()
Куда попадает сообщение: роль ключаспросят на собеседовании
Producer выбирает партицию по правилу:
- Ключ указан →
partition = hash(ключа) % количество_партиций. Все сообщения с одинаковым ключом всегда попадают в одну партицию. - Ключ не указан → aiokafka выбирает случайную доступную партицию (Java-клиент в этом случае держится одной партиции, пока не наберёт пачку). В любом случае порядка между такими сообщениями нет.
Это важно для порядка. Если все события одного заказа должны быть в правильном порядке — используйте order_id как ключ:
# Правильно: ключ — order_id, все события заказа в одной партиции
await producer.send_and_wait("order-events", key=event.order_id.encode(), value=payload)

# Неправильно: без ключа события разлетятся по разным партициям
await producer.send_and_wait("order-events", value=payload)
Важный нюанс: если увеличить количество партиций в существующем топике, формула hash(ключа) % N даст другие результаты. Часть сообщений попадёт в другую партицию — порядок нарушится. Поэтому количество партиций планируют заранее с запасом и не меняют на ходу без миграции данных.
Порядок сообщенийспросят на собеседовании
Внутри одной партиции порядок гарантирован — сообщения хранятся и доставляются именно в том порядке, в котором были записаны.
Между партициями порядок не определён. Если события одного заказа попали в разные партиции, они могут быть прочитаны в произвольном порядке.
Вывод: хотите упорядоченную обработку всех событий какого-то объекта — используйте его идентификатор как ключ сообщения.
Consumer Groups: как потребители делят работуспросят на собеседовании
Consumer Group — это несколько потребителей с одинаковым group_id. Kafka распределяет партиции топика между ними: каждая партиция назначается ровно одному потребителю в группе.
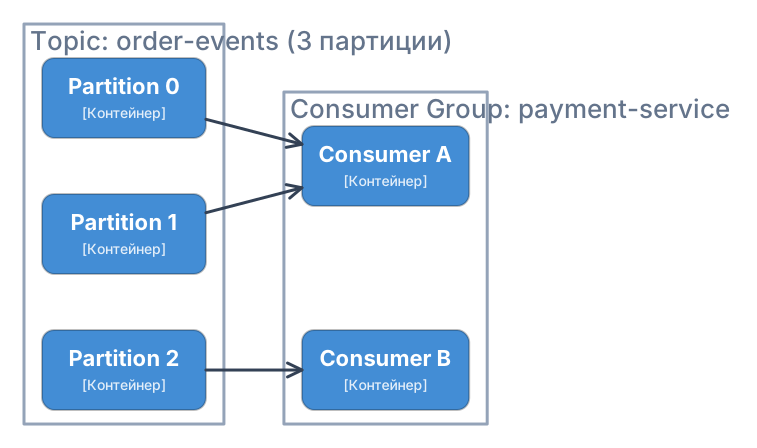
Что это даёт:
- Параллелизм ограничен числом партиций: если партиций 3, а потребителей 5 — двое будут простаивать.
- Каждое сообщение в группе обрабатывается ровно одним потребителем — нагрузка делится, а не дублируется.
- Разные группы независимы:
PaymentServiceиInventoryServiceобе читаютorder-events, но каждая со своим offset — как если бы у каждой была своя копия топика.
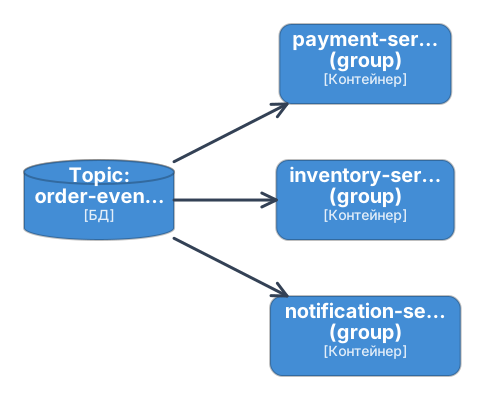
Когда потребитель падает или добавляется новый, Kafka перераспределяет партиции — это называется rebalance. На время перераспределения группа не обрабатывает сообщения. Частые rebalance замедляют работу, поэтому стараются их избегать.
Commit offset: отметка о прогрессеспросят на собеседовании
Потребитель сообщает Kafka, какие сообщения обработал — это называется commit offset. Без этого после перезапуска Kafka не знала бы, откуда продолжать.
Автоматический commit (по умолчанию) фиксирует offset каждые 5 секунд независимо от того, обработано ли сообщение. Удобно, но опасно: если упасть после получения, но до обработки — offset уже зафиксирован, сообщение потеряется.
Ручной commit — надёжнее:
consumer = AIOKafkaConsumer(
    "order-events",
    group_id="payment-service",
    enable_auto_commit=False,
)
await consumer.start()
try:
    async for record in consumer:
        await process_event(record)
        await consumer.commit()  # фиксируем только после успешной обработки
        # исключение в process_event → commit не выполнится → перечитаем после перезапуска
finally:
    await consumer.stop()
С ручным commit'ом потребитель может получить одно сообщение дважды (при перезапуске после сбоя). Это называют at-least-once — и это стандартный подход. Цена: потребитель должен уметь обрабатывать одно и то же сообщение несколько раз без побочных эффектов (быть идемпотентным).
Гарантии доставкиспросят на собеседовании
Kafka поддерживает три режима:
| Режим | Смысл | Применение |
|---|---|---|
| At-most-once | Доставлено или потеряно — без дублей | Метрики, логи, телеметрия |
| At-least-once | Доставлено хотя бы один раз, возможны дубли | Большинство бизнес-сценариев |
| Exactly-once | Ровно один раз, без потерь и дублей | Финансовые операции, критичные к дублям |
At-least-once + идемпотентный потребитель — стандартный выбор для бизнес-событий. Exactly-once технически реализуемо (transactional producer + read-committed consumer), но сложнее и медленнее.
Idempotent Producer
Обычный producer может отправить сообщение дважды, если подтверждение не дошло. С настройкой enable_idempotence=True producer получает у брокера идентификатор и нумерует сообщения в каждой партиции, а брокер отбрасывает повторы с уже виденным номером. aiokafka при этом сам требует acks="all":
producer = AIOKafkaProducer(
    enable_idempotence=True,
    acks="all",
)
Это защищает от дублей при повторных попытках отправки. Но если сам сервис перезапустился и отправляет сообщение заново — это уже другое сообщение с точки зрения Kafka. Поэтому потребители всё равно должны быть идемпотентными.
Атомарность: запись в базу и отправка событияспросят на собеседовании
Распространённая задача: нужно сохранить заказ в базе данных и одновременно отправить событие в Kafka. Если сначала сохранить, а потом отправить — при сбое между этими шагами событие будет потеряно.
Решение — Transactional Outbox: событие записывается в ту же транзакцию базы данных, что и сам заказ. Отдельный фоновый процесс читает необработанные записи и отправляет их в Kafka.
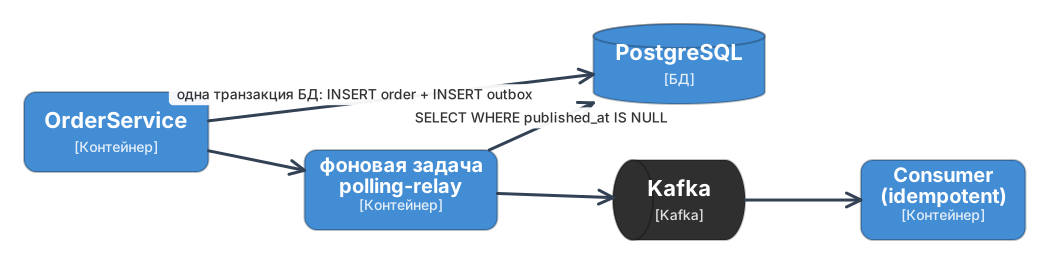
Ничего не теряется (запись атомарна), ничего лишнего не отправляется (relay видит только завершённые записи). Подробнее этот паттерн разобран в статье «Распределённые паттерны».
Репликация: что если сервер упадётспросят на собеседовании
Каждая партиция хранится не на одном сервере, а на нескольких. Один из них — лидер, остальные — реплики. Producers и consumers работают только с лидером. Реплики догоняют лидера и формируют ISR (In-Sync Replicas — синхронизированные реплики). Если лидер падает, одна из реплик становится новым лидером.
Producer указывает, насколько строгое подтверждение ему нужно (acks):
acks | Что значит | Риск |
|---|---|---|
0 | Отправил и забыл | Можно потерять |
1 | Лидер получил | Потеря при падении лидера до репликации |
all | Все синхронизированные реплики получили | Надёжно |
Для бизнес-событий — всегда acks=all.
Срок хранения сообщений
Kafka — это лог, и у него есть настраиваемый срок хранения:
- По времени (
retention.ms) — например, 7 дней. - По размеру (
retention.bytes) — например, 1 ТБ на партицию. - Компакция (
cleanup.policy=compact) — хранится только последнее сообщение для каждого ключа. Подходит для хранения текущего состояния: остатков на складе, актуальных цен, профилей пользователей.
# Топик с компакцией — актуальные остатки
inventory-current:
  cleanup.policy: compact

# Обычный топик событий — 7 дней
order-events:
  cleanup.policy: delete
  retention.ms: 604800000
Когда Kafka не нужна
Kafka хорошо работает для потоков событий с высокой нагрузкой. Но она не для всего:
- Нужен ответ на запрос — Kafka однонаправленная, запрос-ответ через неё громоздко. Лучше HTTP.
- Мало событий — Kafka оптимизирована для высокой нагрузки; для нескольких событий в день это избыточно.
- Нужна сложная маршрутизация по правилам — RabbitMQ с routing-правилами подойдёт лучше.
Глубже: с чего начинает читать новая группа, rebalance и транзакциирасширенноеспросят на собеседовании
Новая группа потребителей по умолчанию начинает с конца: auto_offset_reset="latest" означает
«читать только то, что придёт после подписки». Сервис, который запустили через час после того,
как producer записал тысячу событий, этих событий не увидит, и выглядит это как «Kafka теряет
сообщения». Для бизнес-событий группу создают с auto_offset_reset="earliest": первый запуск
прочитает топик с начала, а дальше позиция берётся из сохранённого offset.
Rebalance запускается не только при падении потребителя. Брокер считает участника живым, пока
тот шлёт heartbeat (каждые 3 секунды, heartbeat_interval_ms) и укладывается в
session_timeout_ms (10 секунд); отдельно aiokafka следит, чтобы между двумя вызовами getmany
проходило меньше max_poll_interval_ms (5 минут). Обработчик, который завис на внешнем вызове
дольше этого, выводится из группы, его партиции раздаются соседям, а после возврата сообщения
обрабатываются второй раз.
Exactly-once в aiokafka собирается из transactional_id у producer, блока
async with producer.transaction():, внутри которого отправляют сообщения и вызывают
send_offsets_to_transaction(...), и isolation_level="read_committed" у потребителя. Это
имеет смысл для цепочек «прочитал из Kafka, записал в Kafka»; когда результат уходит в базу,
проще outbox и идемпотентный потребитель.
Коротко
- Топик — именованный лог событий. Партиция — его физическая часть, упорядоченная и неизменяемая.
- Ключ сообщения определяет партицию: один ключ → одна партиция → порядок гарантирован.
- Offset — позиция потребителя. Commit offset после обработки, не до.
- Consumer Group делит партиции между потребителями. Несколько групп читают один топик независимо.
- Стандартный выбор: at-least-once + ручной commit + идемпотентный потребитель.
- Для атомарности «база + Kafka» — паттерн Transactional Outbox.
- Репликация защищает от потери данных при падении сервера. Для надёжности —
acks=all. - Срок хранения настраивается по времени или размеру; компакция хранит только последнюю версию для каждого ключа.
- Новая группа по умолчанию читает только новые сообщения (
auto_offset_reset="latest"); для бизнес-событий ставятearliest.
Что пощупать
Издатель и потребитель на aiokafka в практикуме remodov/marketplace-system-python: сервис заказов публикует события из outbox с ключом сообщения равным id заказа и заголовками event-id и event-type байтами, сервис уведомлений читает их группой notification; payload собирается по контракту из пакета contracts/orders_v1 на pydantic со strict=True, а не json.dumps внутреннего класса. Тест издателя идёт на настоящей Kafka со стенда.
Код: publisher.py, consumer.py, contracts/orders_v1, test_kafka_publisher.py.
Сделаем сами
Ветка step-10-events-and-contract - запись в outbox и relay вынуты, пять тестов красные.
Что почитать дальше
- Kafka в production — aiokafka и confluent-kafka, Dead Letter Queue, Schema Registry, consumer lag, настройка производительности, безопасность, KRaft.
- Распределённые паттерны — Outbox + polling-relay, Saga, Idempotent Consumer подробно.
- CQRS — Kafka как канал между командной и читающей моделью.