Образ есть — теперь нужно его запустить. В этой статье разберём команду docker run, основные флаги, которые используются каждый день, и то, что происходит с контейнером после старта: как смотреть логи, заходить внутрь и корректно останавливать.
Самое дорогое место здесь — не старт, а остановка: docker stop не выключает контейнер мгновенно, он даёт процессу 10 секунд, и распорядиться ими может только само приложение.
docker stop не выключает контейнер, а выдаёт процессу бюджет в 10 секунд. Перехватил SIGTERM — уложился и вышел сам; не перехватил — получил SIGKILL вместе с оборванными запросами.
Что происходит при запуске
Когда вы пишете docker run, Docker создаёт из образа контейнер — изолированный процесс со своей файловой системой, сетью и переменными окружения — и запускает его.
Короткая формула: образ — это рецепт, контейнер — это работающее блюдо.
Простейший запуск:
docker run eclipse-temurin:21-jre java -version
Docker скачает образ (если его нет локально), создаст контейнер, выполнит команду и завершится. Контейнер остановится, как только процесс внутри завершится.
Основные флаги docker run
Большинство реальных запусков используют несколько флагов вместе. Разберём каждый.
-p: проброс портов
Контейнер живёт в изолированной сети — снаружи до него не достучаться, пока вы явно не откроете порт.
docker run -p 8080:8080 my-spring-app
#              ^     ^
#         хост:контейнер
Левая часть — порт на вашей машине (хосте), правая — порт внутри контейнера. Можно использовать разные номера:
docker run -p 9090:8080 my-spring-app # приложение слушает 8080, снаружи доступно на 9090
-e: переменные окружения
Это основной способ передавать конфигурацию в контейнер — пароли к базе данных, URL внешних сервисов, профили Spring Boot. Каждая переменная — отдельный флаг -e:
docker run \
  -e SPRING_PROFILES_ACTIVE=prod \
  -e DB_URL=jdbc:postgresql://db:5432/myapp \
  -e DB_PASSWORD=secret \
  my-spring-app
Spring Boot видит все переменные окружения и умеет подставлять их в конфигурацию: в application.yml пишете ${DB_URL} — и значение приедет из -e DB_URL=....
Но «видит» и «настраивает сама» — разные вещи. Само собой, без единой строчки в конфигурации, подхватываются только имена, собранные по правилам Spring: SPRING_DATASOURCE_URL превращается в свойство spring.datasource.url, SERVER_PORT — в server.port. Переменная DB_URL придумана вами, никакого готового свойства за ней не стоит — и работать она будет ровно там, где вы сами на неё сослались.
-d: фоновый режим
По умолчанию docker run держит терминал занятым — вывод идёт прямо в консоль. Флаг -d (detached) запускает контейнер в фоне и сразу возвращает управление:
docker run -d -p 8080:8080 my-spring-app
Docker выведет идентификатор контейнера и всё. Логи смотреть отдельно — об этом ниже.
--name: имя контейнера
По умолчанию Docker придумывает имена вроде elegant_hopper — не очень удобно. Задайте своё:
docker run -d --name my-app -p 8080:8080 my-spring-app
Теперь к контейнеру можно обращаться по имени во всех командах: docker logs my-app, docker stop my-app.
--rm: автоудаление
Если контейнер нужен разово (прогнать тест, выполнить скрипт), флаг --rm удалит его автоматически при остановке:
docker run --rm my-spring-app java -jar app.jar --check-config
Без --rm остановленные контейнеры накапливаются и занимают место.
Всё вместе — типичный запуск
docker run -d \
  --name my-app \
  -p 8080:8080 \
  -e SPRING_PROFILES_ACTIVE=prod \
  -e DB_URL=jdbc:postgresql://db:5432/myapp \
  my-spring-app:1.0
--rm здесь намеренно нет. Он хорош для разовых запусков, а для долгоживущего приложения оборачивается неприятностью: контейнер упал — и тут же исчез вместе со своими логами, смотреть docker logs уже не на чем и код выхода посмотреть негде.
Автоматический перезапуск: --restart
По умолчанию упавший контейнер остаётся лежать: процесс вышел — и всё. На машине разработчика это удобно (видно, что упало), а для чего-то, что должно работать постоянно, нужен флаг перезапуска.
docker run -d --name my-app --restart unless-stopped my-app:1.0
Значений четыре, и выбирают между двумя из них:
| Значение | Что делает |
|---|---|
no | ничего, поведение по умолчанию |
on-failure[:N] | перезапускает только при ненулевом коде выхода, не больше N раз |
always | перезапускает всегда, в том числе после перезагрузки машины, даже если контейнер остановили руками |
unless-stopped | то же, что always, но остановленный вручную контейнер после перезагрузки не поднимается |
unless-stopped — разумный выбор по умолчанию для локальной базы, брокера или приложения на одиночном сервере: переживает перезагрузку хоста и не воскресает, если вы его сознательно остановили. on-failure:5 подходит задачам, которые должны отработать и выйти: нормальный выход не перезапускается, а падения повторяются ограниченное число раз.
Три оговорки, без которых флаг разочарует.
Docker увеличивает паузу между попытками (с сотен миллисекунд, удваивая), поэтому контейнер, падающий из-за опечатки в настройках, перезапускается всё реже, а не в бесконечном цикле. Это видно в docker ps как Restarting (1) 5 seconds ago.
Перезапуск после перезагрузки машины работает только если сама служба Docker запускается при старте системы — на большинстве дистрибутивов так и есть, но на своём сервере это стоит проверить.
И главное: перезапуск смотрит только на выход процесса. Зависшее приложение, которое не отвечает, но и не падает, не перезапустится никогда — проверка работоспособности из раздела ниже это заметит, а перезапустить не сможет. Этим и отличается оркестратор: там неудачная проба ведёт к перезапуску.
Передача конфигурации через переменные окружения
Если адрес базы и пароль зашиты в образ, для тестового и боевого окружения придётся собирать два разных образа — и тот, что проверили, окажется не тем, что выкатили. Поэтому конфигурация не хранится внутри образа, а приходит снаружи при запуске — это идея из методологии 12-factor app: один и тот же образ разворачивается в разных окружениях (разработка, тестирование, продакшн) с разными переменными.
Для Spring Boot это выглядит так: в application.yml вы пишете ${DB_URL}, а конкретное значение передаёте через -e DB_URL=... при запуске контейнера. Ни один секрет не попадает в образ.
Если переменных много, удобно вынести их в файл:
# .env
SPRING_PROFILES_ACTIVE=prod
DB_URL=jdbc:postgresql://db:5432/myapp
DB_PASSWORD=secret
docker run -d --env-file .env -p 8080:8080 my-spring-app
Только не коммитьте .env с реальными паролями в репозиторий.
Жизненный цикл контейнера
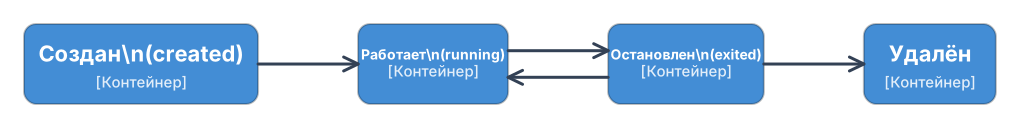
После запуска контейнер проходит через несколько состояний. docker create заводит контейнер в состоянии created: файловая система уже есть, процесс ещё не запущен; docker start переводит его в running, docker stop — в exited. Остановленный контейнер не исчезает: его слой с записанными файлами лежит на диске и занимает место, пока его не удалят docker rm.
Команды для управления:
docker ps                  # список работающих контейнеров
docker ps -a               # все, включая остановленные
docker stop my-app         # мягкая остановка (SIGTERM, затем SIGKILL через 10 с)
docker start my-app        # запустить остановленный контейнер
docker rm my-app           # удалить остановленный контейнер
docker rm -f my-app        # остановить и удалить сразу
docker stop отправляет процессу сигнал SIGTERM — приложение может его перехватить и завершиться корректно (закрыть соединения с базой, дождаться текущих запросов). Через 10 секунд Docker принудительно убивает процесс через SIGKILL.
Десять секунд — это значение по умолчанию, и его меняют, когда приложению нужно больше: дождаться долгих запросов, дописать пачку в базу, отпустить блокировку.
docker stop -t 30 my-app     # дать 30 секунд вместо 10
docker run --stop-timeout 30 ...   # задать срок сразу при создании контейнера
И тут бывает неприятный сюрприз: срок увеличили, а контейнер всё равно умирает ровно на десятой секунде с кодом 137. Это значит, что SIGTERM вообще не доходит до приложения, и увеличивать срок бессмысленно — надо чинить причину. Их три.
Первым процессом стал shell. Если ENTRYPOINT записан строкой, а не массивом, номер 1 достаётся /bin/sh, а он сигнал дочернему процессу не передаёт. Разбор — в статье про Dockerfile; лечится exec-формой.
Процесс не обрабатывает SIGTERM. Spring Boot обрабатывает его сам, а вот скрипт-обёртка или приложение без обработчика — нет; тогда сигнал игнорируется, и всё равно случится SIGKILL.
Приложению нужен другой сигнал. Некоторые программы завершаются по SIGQUIT или SIGINT, а SIGTERM для них означает другое. Какой сигнал посылать, задают в образе инструкцией STOPSIGNAL:
STOPSIGNAL SIGQUIT
Проверить, что остановка действительно корректная, проще всего по времени и коду: time docker stop my-app должен отработать быстрее отведённого срока, а docker ps -a показать Exited (0) или Exited (143), но не Exited (137).
Чем всё закончилось, видно в docker ps -a по коду выхода. Exited (0) — процесс вышел сам и по-хорошему. Exited (143) — вышел по SIGTERM: 128 плюс номер сигнала, а SIGTERM пятнадцатый. Exited (137) — это 128 плюс девять, то есть SIGKILL: процесс либо не уложился в отведённые 10 секунд, либо его убило ядро за перерасход памяти. Так что 137 — почти всегда повод посмотреть на лимит памяти контейнера.
Логи: docker logs
Всё, что приложение пишет в stdout и stderr, Docker собирает автоматически.
docker logs my-app            # вывести все накопленные логи
docker logs -f my-app         # следить за логами в реальном времени (как tail -f)
docker logs --tail 100 my-app # последние 100 строк
Spring Boot по умолчанию пишет в stdout — ничего дополнительно настраивать не нужно. Если приложение пишет в файл внутри контейнера, docker logs этот файл не увидит.
Зайти внутрь: docker exec
Иногда нужно посмотреть, что происходит внутри работающего контейнера — проверить файловую систему, переменные окружения, сетевые соединения.
Сразу оговорка, которая экономит полчаса недоумения: шелл есть не в каждом образе. docker exec -it my-app sh работает в eclipse-temurin, debian, alpine — там оболочка внутри лежит. В минимальных образах (distroless, scratch, урезанные сборки) её нет вовсе, и команда отвечает exec: "sh": executable file not found in $PATH. Это не поломка, а смысл таких образов: чем меньше внутри, тем меньше поверхность атаки, о чём статья про промышленные образы.
Что делать, когда зайти внутрь всё-таки надо:
- Посмотреть снаружи. Большая часть вопросов закрывается без входа:
docker logs,docker inspect(переменные, точки монтирования, сеть),docker top my-app(процессы),docker diff my-app(что изменилось в файловой системе),docker cp my-app:/tmp/heap.hprof .(забрать файл). - Подключить отладочный контейнер к тому же пространству имён. Соседний контейнер с нужными утилитами запускают в сети и пространстве процессов целевого:
docker run -it --rm --pid=container:my-app --network=container:my-app nicolaka/netshoot sh. Дальше видно и процессы, и сеть контейнера, а инструменты приезжают из отладочного образа. - Собрать отладочный вариант своего образа. Многоэтапная сборка позволяет иметь второй финальный этап с обычной базой и утилитами —
--target debug; в проде идёт минимальный, в отладке запускают отладочный, о чём статья про многоэтапную сборку.
В distroless есть и готовый компромисс: теги с суффиксом :debug содержат простую оболочку (busybox) — тот же образ, но с возможностью зайти внутрь.
docker exec -it my-app sh     # запустить shell внутри контейнера
docker exec -it my-app bash   # если bash есть в образе
Флаги -it означают: -i — передавать ввод с клавиатуры, -t — подключить псевдотерминал. Вместе они дают интерактивную сессию.
Внутри можно проверить переменные:
env | grep SPRING
Или посмотреть, какие процессы запущены:
ps aux
docker exec не перезапускает приложение — команда выполняется рядом с уже работающим процессом.
Healthcheck: проверка работоспособности
Docker умеет периодически проверять, жив ли контейнер — не просто процесс запущен, а приложение реально отвечает. Это healthcheck.
Проще всего задать его в Dockerfile:
HEALTHCHECK --interval=30s --timeout=5s --retries=3 \
  CMD wget -qO- http://localhost:8080/actuator/health || exit 1
Для приложения на Spring Boot этой строки мало, и правильный вариант выглядит так:
HEALTHCHECK --interval=30s --timeout=5s --retries=3 --start-period=40s \
  CMD wget -qO- http://localhost:8080/actuator/health/readiness || exit 1
Разберём параметры, потому что каждый из них отвечает за конкретную неприятность. --interval — как часто проверять. --timeout — сколько ждать ответа; проба, которая сама висит, считается неудачной. --retries — сколько подряд неудач нужно, чтобы контейнер стал unhealthy; единица даёт ложные срабатывания на случайной задержке.
--start-period — самый важный и самый часто забываемый. Это время на запуск, в течение которого неудачные пробы не считаются: контейнер остаётся в состоянии starting, а не становится unhealthy. Приложение на Spring Boot поднимается 10–40 секунд, и без этого параметра оркестратор успевает решить, что контейнер неработоспособен, и перезапустить его — снова и снова, потому что новый экземпляр стартует ровно так же. Узнаваемый признак: контейнер бесконечно перезапускается, а в логах при этом виден нормальный старт, оборванный на середине.
Тонкость: как только первая проба прошла успешно, период запуска заканчивается досрочно — то есть большой --start-period не замедляет быстрый старт, а только даёт запас медленному. Поэтому его ставят с двойным запасом от обычного времени старта, а не «в притирку».
После старта контейнер некоторое время находится в состоянии starting — Docker ждёт, пока healthcheck пройдёт впервые. Потом переходит в healthy или unhealthy.
Пока идёт --start-period, неудачные пробы не считаются и контейнер держится в starting; дальше срабатывают retries, и статус, который docker ps печатает в скобках, становится healthy или unhealthy.
Команда в пробе должна существовать внутри образа — это первое, обо что спотыкаются. В eclipse-temurin есть и wget, и curl, так что строка выше работает как есть. А вот в минимальных базах вроде distroless нет ни того, ни другого, ни даже оболочки: там проверку либо оставляют оркестратору, либо пишут маленький Java-класс и зовут его через CMD ["java", ...].
Посмотреть статус:
docker inspect --format='{{.State.Health.Status}}' my-app
Здесь легко обмануться. Сам по себе healthcheck ничего не перезапускает — он только меняет статус контейнера. Не помогает и Docker Compose: политика restart: смотрит на то, вышел ли процесс, а не на результат проверки, так что зависшее приложение со статусом unhealthy будет висеть дальше. Реагировать на проверку умеют оркестраторы — Docker Swarm и Kubernetes: там неудачная проба и правда приводит к перезапуску.
Два разных вопроса: «жив» и «готов»
Важно различать два вопроса. «Жив» — процесс не завис и его не нужно перезапускать; ответ не должен зависеть от базы или соседних сервисов, иначе их сбой вызовет каскад рестартов.
«Готов» — приложение прогрелось, миграции прошли, соединение с базой есть; пока ответ «нет», трафик на контейнер не идёт, но перезапускать его не надо.
Проверка корневого пути отвечает лишь на первый вопрос: веб-сервер поднимается раньше, чем приложение готово. В HEALTHCHECK ставят эндпоинт готовности (в Spring Boot — /actuator/health/readiness) и --start-period, чтобы медленный старт не считался провалом; в Kubernetes эти вопросы разнесены по разным пробам.
Глубже: лимиты ресурсов: память, процессор, число процессоврасширенное
Флаги --memory и --cpus мелькают в примерах статьи про JVM, а что они делают и что будет без них, стоит разобрать отдельно, потому что без лимитов один контейнер валит соседей.
Контейнер это обычный процесс на ядре хоста, и без лимита он берёт столько памяти и процессора, сколько захочет. Утечка памяти в одном сервисе съедает всю память машины, и убийца нехватки памяти в ядре выбирает жертву по своим правилам, обычно самый большой процесс, которым может оказаться база данных в соседнем контейнере. Лимит переводит эту историю внутрь контейнера: превысил свою память, убит сам, с кодом 137, а соседи живы. Лимиты ставят механизмы ядра, cgroups, и Docker лишь передаёт им числа.
docker run --memory=512m --memory-swap=512m --cpus=1.5 --pids-limit=200 myapp
--memory это потолок оперативной памяти; --memory-swap, равный ему, запрещает контейнеру уходить в подкачку, иначе вместо быстрого 137 получите медленную смерть с диском в качестве памяти. --cpus=1.5 это доля процессорного времени, полтора ядра в среднем за период, а не привязка к конкретным ядрам; при нехватке контейнер не убивают, а притормаживают, и это видно как рост задержек без ошибок. --pids-limit ограничивает число процессов и потоков, и это защита от вилочной бомбы и от пула потоков, который разросся до тысяч.
Что смотреть: docker stats показывает текущее потребление относительно лимита в реальном времени, docker inspect с .State.OOMKilled подтверждает, что убийство было за память. Лимит меняют на ходу через docker update --memory=1g my-app без перезапуска.
Правила выбора чисел. Память: измеренное потребление под нагрузкой плюс запас на выбросы, и для JVM оттуда же считается куча, о чём статья про JVM в контейнерах. Процессор: не меньше одного ядра для сервиса с пулом потоков, иначе сборщик мусора и запросы делят одно ядро и задержки скачут. И лимиты обязаны быть у всех контейнеров на общей машине, а не только у «подозрительных»: без лимита у одного остальные лимиты не защищают ни от чего. В Kubernetes те же числа называются resources.limits и requests, и там они ещё и решают, на какой узел попадёт под.
Глубже: логи растут, пока не забьют диск: драйверы и ротациярасширенное
docker logs читает то, что Docker сохранил, и по умолчанию сохраняет он всё: драйвер json-file пишет каждую строку stdout в файл /var/lib/docker/containers/<id>/<id>-json.log без ограничения размера. Сервис, который пишет по строке на запрос, за месяц оставляет гигабайты, и однажды диск заканчивается, причём страдает не он, а база в соседнем контейнере, которой некуда записать.
Ротацию включают явно, на контейнер или для всего демона:
docker run --log-opt max-size=10m --log-opt max-file=3 myapp
Три файла по десять мегабайт, старое стирается. Для всех контейнеров то же пишут в /etc/docker/daemon.json в разделе log-opts, и это первое, что делают на новой машине с Docker. Драйвер local вместо json-file ротирует сам (сто мегабайт в пяти файлах по умолчанию) и сжимает старое; менять на него можно тем же daemon.json.
Другие драйверы отправляют журнал мимо диска: journald в системный журнал машины, syslog, fluentd и gelf в сборщик журналов. С ними docker logs перестаёт работать (кроме journald и local), и это цена за то, что журнал живёт в общем хранилище, а не на диске узла. В Kubernetes журналы контейнеров ротирует сам узел, а собирает агент, и там docker logs заменяется на kubectl logs.
Правило для приложения одно: писать в stdout и stderr, а не в файл внутри контейнера. Файл внутри контейнера не видит ни docker logs, ни сборщик, и он исчезает вместе с контейнером; если библиотека умеет только файл, его выводят на /dev/stdout ссылкой. Про то, каким должен быть сам журнал (структура, уровни, идентификатор запроса), говорит раздел про наблюдаемость.
Глубже: диагностика: inspect, events, diff и контейнер, который падает сразурасширенное
Код выхода из раздела про жизненный цикл говорит, чем кончилось; дальше нужны три команды и один приём.
docker inspect my-app отдаёт всё, что Docker знает о контейнере, и смотрят в нём раздел State: ExitCode, OOMKilled, Error (текст, если Docker сам не смог запустить процесс), StartedAt и FinishedAt, по которым видно, прожил контейнер секунду или сутки. Дальше Config с фактическими переменными окружения и командой (то, что реально запустилось, а не то, что вы думали), Mounts и NetworkSettings с адресами. Формат --format '{{.State.ExitCode}}' вытаскивает одно поле для скриптов.
docker events --since 30m показывает ленту событий демона: start, die с кодом, oom, kill, health_status: unhealthy. По ней видно, что контейнер за полчаса перезапускался двадцать раз политикой перезапуска, чего в docker ps не видно вовсе.
docker diff my-app перечисляет файлы, которые изменились в файловой системе контейнера с момента старта. Растущий список в /tmp или /app/logs означает, что приложение пишет туда, где данные пропадут, а разросшийся слой контейнера это то, что съедает диск незаметно для docker system df.
Контейнер, который падает сразу после старта, разбирают в таком порядке. docker logs my-app работает и для остановленного контейнера, пока его не удалили, и там обычно ответ: не найден класс, не задана переменная, нет доступа к файлу после USER. Пустой лог означает, что до приложения дело не дошло: docker inspect покажет Error, а код 126 и 127 это «не исполняемый файл» и «команда не найдена», ошибка в ENTRYPOINT или в путях; exec format error это чужая архитектура образа. Дальше запускают тот же образ с другой командой, docker run -it --entrypoint sh myapp, и проверяют изнутри руками: есть ли файл, какие права, какие переменные; у образов без оболочки (distroless) для этого есть вариант :debug. Последний приём: тот же контейнер без -d, чтобы видеть вывод сразу, и без политики перезапуска, которая маскирует падения бесконечным Restarting.
Коротко
docker runсоздаёт контейнер из образа и запускает его; при завершении процесса контейнер останавливается.-p host:container— проброс порта; без него к контейнеру не подключиться снаружи.-e KEY=VALUE— передать переменную окружения; это основной способ конфигурации по принципу 12-factor.-d— фоновый режим;--name— удобное имя;--rm— удалить контейнер после остановки.docker logs -f— следить за логами в реальном времени;docker exec -it ... sh— интерактивная сессия внутри.docker stopпосылаетSIGTERM, даёт приложению 10 секунд на корректное завершение. Срок остановки задаютdocker stop -tили--stop-timeout, нужный сигнал — инструкциейSTOPSIGNAL; если контейнер всё равно умирает на десятой секунде с кодом 137,SIGTERMне доходит до приложения.- Healthcheck проверяет, что приложение не просто запущено, а реально отвечает.
--start-periodв проверке обязателен для JVM-приложений: без него медленный старт читается как неработоспособность и даёт бесконечный перезапуск. - Без лимитов контейнер валит соседей:
--memoryс равным--memory-swap,--cpusкак доля времени,--pids-limit; превышение памяти это137только у виновного;docker statsиdocker update. - Журнал
json-fileрастёт без предела:max-sizeиmax-fileвdaemon.jsonили драйверlocal; приложение пишет вstdout, а не в файл. - Разбор:
docker inspectсStateиConfig,docker eventsдля перезапусков,docker diffдля записи не туда; упавший сразу контейнер читают черезlogs, затем--entrypoint shвнутрь. --restart unless-stoppedдля того, что должно работать постоянно,on-failure:Nдля задач; перезапуск смотрит только на выход процесса, поэтому зависшее приложение он не спасёт.- В distroless и
scratchнет оболочки: вместоdocker execсмотрятlogs,inspect,top,diff, подключают отладочный контейнер через--pid=container:или собирают отладочный этап образа.
Что почитать дальше
- Что такое Docker и зачем он нужен — если ещё не читали: образы, слои, изоляция с нуля.
- Тома и данные — как сохранить данные между перезапусками контейнера.
- Сеть в Docker — как контейнеры общаются друг с другом и с внешним миром.