Пока приложение одно, клиент знает один адрес, токен проверяет один фильтр, и адрес не меняется от выката к выкату. Разбейте его на десять сервисов — и каждое «один» превращается в «десять»: десять адресов у клиента, десять проверок JWT, экземпляры, которые появляются и исчезают при каждом выкате, и старый монолит, который никуда не делся. Структурные паттерны — ответы на вопросы, которые возникают от самого факта разбиения: кто стоит на входе, как сервисы находят друг друга, кто берёт на себя шифрование и повторы, как переехать с монолита, не останавливая разработку.
Самый частый из этих вопросов — кто проверяет токен. Ниже видно, что меняется, когда проверку выносят на вход, и на каком условии это держится.
Шлюз убирает не работу, а её десять копий: токен проверяется один раз, внутрь идёт X-User-Id. Верить этому заголовку можно только там, где мимо шлюза к сервисам не пройти.
С чего начать и когда всё это не нужно
Каждый паттерн ниже — ещё один компонент в эксплуатации: его разворачивают, обновляют, мониторят и чинят, когда он падает. Шлюз, реестр, mesh и BFF — четыре таких компонента; команда из пяти человек, которая тянет ещё и сами сервисы, все четыре не потянет. Берут по одному и под конкретную боль.
Первым появляется шлюз: один адрес для клиента, одна проверка токена. Вторым — способ находить сервисы: в Kubernetes он встроен, вне его нужен реестр вроде Consul или Eureka. На этом система из пяти-семи сервисов живёт годами. BFF нужен со вторым типом клиентов, агрегация — когда мобильный экран собирает три вызова по медленной сети, ACL — при первой интеграции с чужой моделью данных. Service Mesh начинается от нескольких десятков сервисов на разных языках или там, где шифрование между всеми сервисами требует регулятор. Strangler Fig — только когда есть монолит, с которого переезжают.
«Пригодится, когда вырастем» — не причина: компонент, который ничего не снимает сегодня, всё равно падает — и как раз когда у команды нет на него времени.
API Gateway: одна дверь вместо десяти адресов
Мобильное приложение ходит в заказы, оплату и доставку по трём адресам; появился четвёртый сервис — выпускайте новую версию приложения. Токен проверяется в каждом из четырёх, лимит считается в каждом по-своему, а CORS настроен в трёх, потому что про четвёртый забыли. Шлюз ставят перед всеми, чтобы клиент знал один адрес, а сквозные проверки делались один раз.
Внутри шлюз — правила, куда отправить запрос: по пути, по заголовку вроде X-API-Version, по весу. Вес даёт постепенное переключение: новая версия каталога получает пятую часть трафика, и если ошибки не растут, долю поднимают.
Шлюз выбирает получателя по пути и по весу; долю новой версии каталога меняют настройкой, а клиент по-прежнему знает один адрес.
spring:
  cloud:
    gateway:
      server:
        webflux:
          routes:
            - id: order-service
              uri: lb://order-service
              predicates:
                - Path=/api/orders/**
              filters:
                - StripPrefix=1
                - name: RequestRateLimiter
                  args:
                    key-resolver: "#{@ipKeyResolver}"
                    redis-rate-limiter.replenishRate: 10
                    redis-rate-limiter.burstCapacity: 20
            - id: catalog-new
              uri: lb://catalog-service-v2
              predicates:
                - Path=/api/catalog/**
                - Weight=catalog, 20
            - id: catalog-old
              uri: lb://catalog-service-v1
              predicates:
                - Path=/api/catalog/**
                - Weight=catalog, 80
Префикс spring.cloud.gateway.server.webflux появился в Spring Cloud 2025.0; раньше те же ключи лежали прямо под spring.cloud.gateway, и короткий вариант объявлен устаревшим. key-resolver у лимитера обязателен: без него ключом становится имя пользователя, а токен на этом шаге ещё не разобран — ключ пустой, и шлюз ответит 403 на всё подряд. Счётчик лимитера живёт в Redis, чтобы реплики шлюза видели одно окно; если Redis недоступен, лимитер Spring Cloud Gateway пропускает всё — «лучше без лимита, чем без сервиса», и отказ Redis выглядит не как ошибка, а как пропавший лимит.
Вторая половина работы шлюза — снять с сервисов одинаковое: SSL, проверку подписи JWT, лимиты, CORS, заголовки безопасности. Токен разбирается один раз, внутрь уходит готовый X-User-Id:
@Component
public class GlobalAuthFilter implements GlobalFilter, Ordered {

    private final JwtDecoder jwtDecoder;

    public GlobalAuthFilter(JwtDecoder jwtDecoder) {
        this.jwtDecoder = jwtDecoder;
    }

    @Override
    public Mono<Void> filter(ServerWebExchange exchange, GatewayFilterChain chain) {
        ServerHttpRequest.Builder request = exchange.getRequest().mutate()
            .headers(headers -> headers.remove("X-User-Id"));
        String token = exchange.getRequest().getHeaders().getFirst(HttpHeaders.AUTHORIZATION);
        if (token == null || !token.startsWith("Bearer ")) {
            exchange.getResponse().setStatusCode(HttpStatus.UNAUTHORIZED);
            return exchange.getResponse().setComplete();
        }
        try {
            Jwt jwt = jwtDecoder.decode(token.substring(7));
            List<String> roles = jwt.getClaimAsStringList("roles");
            request.header("X-User-Id", jwt.getSubject())
                .header("X-User-Roles", roles == null ? "" : String.join(",", roles));
            return chain.filter(exchange.mutate().request(request.build()).build());
        } catch (JwtException e) {
            exchange.getResponse().setStatusCode(HttpStatus.UNAUTHORIZED);
            return exchange.getResponse().setComplete();
        }
    }

    @Override
    public int getOrder() { return -1; }
}
Первая строка метода важнее остальных: входящий X-User-Id затирается до любых проверок. Клиент присылает X-User-Id: 777 сам, и как только появляется маршрут без токена — публичный каталог, проверка здоровья, — заголовок доезжает до сервиса нетронутым. Проверка прав в сервисе не спасёт: сервис честно проверит, что заказ принадлежит пользователю 777, и отдаст его, потому что уверен, что пришёл 777. Отдельный RemoveRequestHeader в default-filters отработает позже фильтра с order -1 и сотрёт уже поставленный заголовок — поэтому затирание живёт в том же фильтре, что и установка. Ролей в токене может не быть: getClaimAsStringList вернёт null, и String.join упадёт уже после проверки подписи.
Второе условие — мимо шлюза к сервисам хода нет: в Kubernetes это ClusterIP без NodePort и NetworkPolicy, которая пускает трафик к сервисам только от подов шлюза (как — в статье о сети Kubernetes). Где такой гарантии нет, токен проверяют и внутри.
На шлюз не выносят права на конкретный ресурс и проверку тела запроса: шлюз знает, что пришёл пользователь 42, но не знает, что заказ 15 принадлежит пользователю 43, — это знает только сервис заказов. Правило «менеджер видит заказы своего региона» на шлюзе делает его вторым монолитом, который меняют все команды сразу.
Шлюз — ещё и точка отказа, и лишний сетевой переход на каждом запросе. Переход стоит доли миллисекунды внутри ЦОДа плюс разбор токена — дешевле десяти проверок в десяти сервисах. От отказа спасает отсутствие состояния: счётчики в Redis, сессий нет, три реплики за обычным балансировщиком — упала одна, две держат трафик. Кэш ответов или сессия в шлюзе делают реплики невзаимозаменяемыми, и отказ одной виден клиентам.
Не берут при одном-двух сервисах: лишний переход и ещё один компонент без выгоды; сквозные задачи там решает библиотека.
Gateway Aggregation: три вызова за один круг
Экран заказа показывает заказ, имя покупателя и статус доставки — три сервиса. Браузер на проводе сделает три запроса и не заметит, а мобильное приложение на 4G с задержкой 100 мс на круг потратит 300 мс на одно ожидание сети. Шлюз может принять один запрос, сам обойти сервисы и вернуть один ответ.
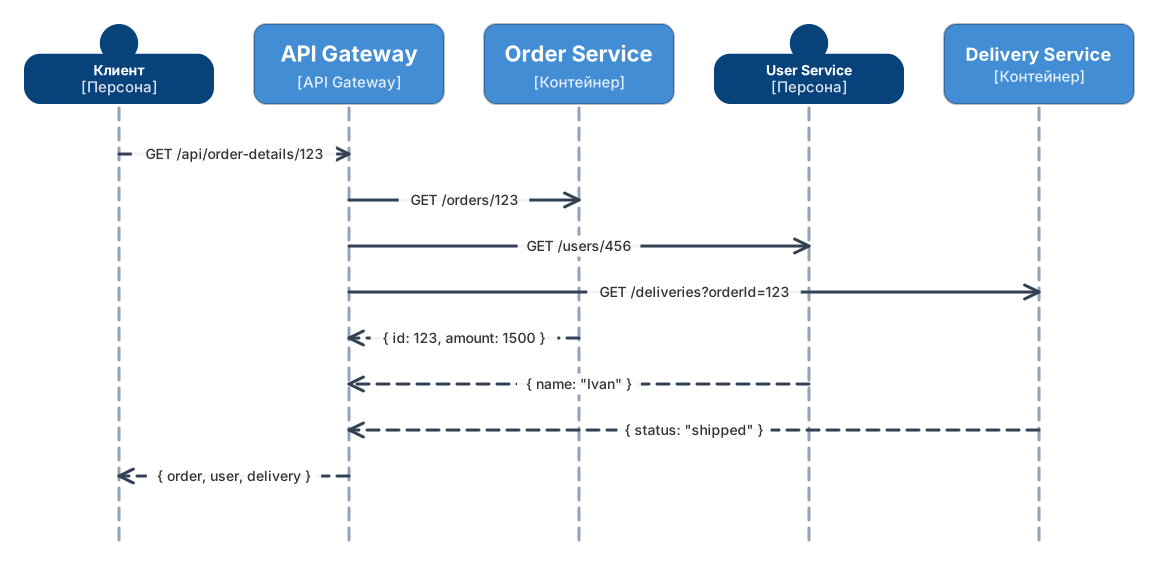
Клиент платит за один круг по медленной сети, три вызова идут по быстрой внутренней. Ответ готов, когда ответил самый медленный из трёх, — поэтому у каждого вызова свой тайм-аут.
@GetMapping("/api/order-details/{orderId}")
public Mono<OrderDetailsResponse> orderDetails(@PathVariable Long orderId) {
    Mono<Optional<OrderDto>> order = orderClient.order(orderId)
        .timeout(Duration.ofMillis(300))
        .map(Optional::of).defaultIfEmpty(Optional.empty())
        .onErrorReturn(Optional.empty());
    Mono<Optional<DeliveryDto>> delivery = deliveryClient.byOrder(orderId)
        .timeout(Duration.ofMillis(300))
        .map(Optional::of).defaultIfEmpty(Optional.empty())
        .onErrorReturn(Optional.empty());
    return Mono.zip(order, delivery)
        .map(t -> new OrderDetailsResponse(t.getT1().orElse(null), t.getT2().orElse(null)));
}
Два вызова независимы и уходят одновременно; ответ ждёт самого медленного, поэтому у каждого свой тайм-аут — иначе зависшая доставка задержит и заказ, который пришёл за 20 мс. defaultIfEmpty обязателен: Mono.zip завершается пустым, если пуст хотя бы один источник, и вместо частичного ответа клиент получил бы ничего. onErrorReturn превращает отказ доставки в пустое поле — решение продукта: экран без статуса доставки лучше ошибки на весь экран. Имя покупателя лежит в заказе, поэтому его вызов идёт через flatMap после первого и удлиняет круг на своё время.
Граница простая: собрать поля рядом — да, решить что-то по ним — нет. «Если доставка задержана, показать кнопку компенсации» — уже логика клиента, и ей место в BFF.
Не берут, когда клиенту хватает одного сервиса или собирать нужно по-разному для разных клиентов — это следующий паттерн.
Backend for Frontend: свой сервис у каждого типа клиента
Мобильному приложению нужно пять полей заказа из сорока, админке — все сорок плюс журнал действий из другого сервиса. Общий API отдаёт всем всё: мобильное приложение качает лишнее, админка делает три запроса вместо одного, а каждый новый экран просит «ещё одно поле» у команды бэкенда. BFF — отдельный сервис на тип клиента: ходит в доменные сервисы и собирает ровно тот ответ, который нужен этому клиенту.
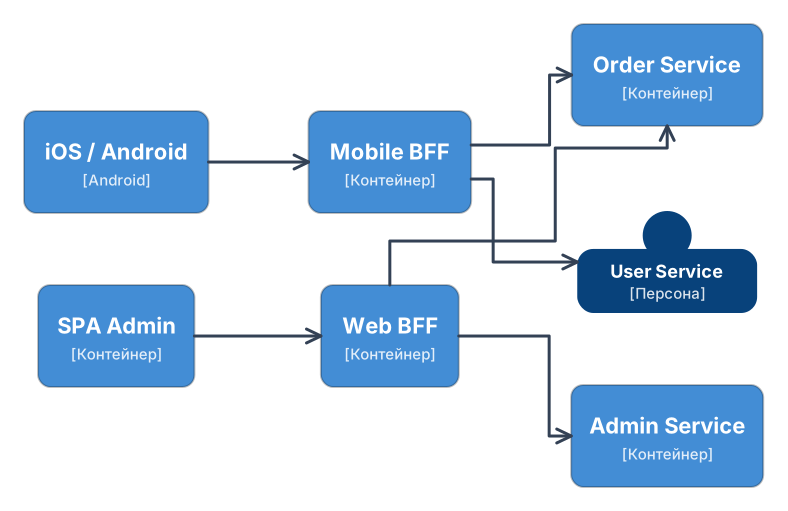
Два клиента — два BFF, у каждого свой владелец. Доменные сервисы под ними общие, и правило «можно ли отменить заказ» живёт только там.
@GetMapping("/api/orders/{id}")
public MobileOrderResponse order(@PathVariable Long id) {
    OrderDto order = orderClient.order(id);
    UserDto user = userClient.user(order.userId());
    return new MobileOrderResponse(order.id(), order.status(), order.total(), user.firstName());
}
Главное в BFF не код, а владелец: команда клиента — мобильная, фронтенда, — а не платформа. Она знает, какие поля нужны экрану, и меняет BFF вместе с экраном, не дожидаясь очереди у команды заказов. Отсюда правило размножения: BFF заводят на тип клиента — мобильный, веб, партнёрский API, — а не на экран; пять BFF на пять экранов — пять сервисов, которые ходят в одни и те же доменные сервисы одним способом.
Опасность одна — в BFF натаскивают бизнес-логику. «Можно ли отменить заказ» посчитали в мобильном BFF, потом чуть иначе в веб-BFF — и у двух клиентов два ответа на один вопрос. Правило живёт в сервисе заказов; BFF решает только, как показать.
Со шлюзом BFF не конкурирует, а стоит за ним: шлюз проверяет токен и маршрутизирует, ничего не зная про экраны; BFF знает про экраны всё. Резать ответ на шлюзе по User-Agent — переносить в шлюз работу BFF, и через полгода шлюз знает про экраны всех клиентов.
Не берут при одном типе клиента: тогда это просто ещё один сервис между шлюзом и доменом.
Sidecar: инфраструктура рядом с процессом, а не внутри него
Метрики, шифрование трафика, повторы и тайм-ауты нужны каждому сервису. Пока все на Java, это библиотека вроде Resilience4j. Появился сервис на Go — пишите свою; на Python — третью. Три реализации расходятся в деталях, и «повтор» на Java и на Go ведут себя по-разному в один и тот же инцидент. Sidecar выносит эту работу в соседний процесс: рядом с сервисом запускается прокси, весь трафик идёт через него, и настройка одна для любого языка.
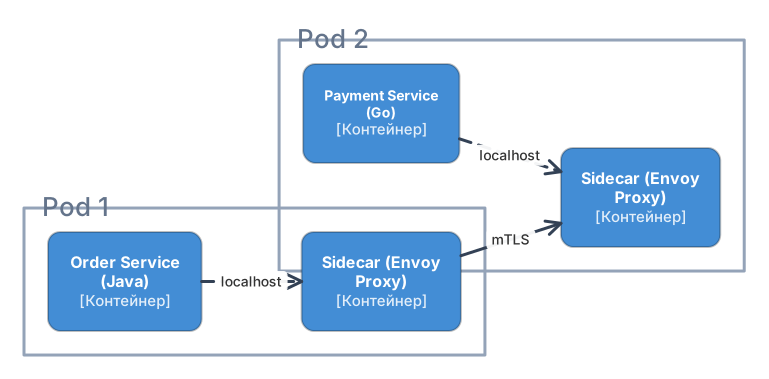
Шифрует не сервис, а прокси рядом, поэтому Java и Go шифруют одинаково: внутри Pod трафик идёт по localhost открытым, между Pod — по mTLS между двумя Envoy.
spec:
  containers:
    - name: order-service
      image: order-service:1.0
      ports:
        - containerPort: 8080
    - name: envoy-sidecar
      image: envoyproxy/envoy:v1.39.1
      ports:
        - containerPort: 15001
        - containerPort: 15006
Одного описания мало: два контейнера встанут рядом, а трафик сервиса как шёл напрямую, так и пойдёт — прокси будет запущен и бездействовать. Чтобы трафик пошёл через него, в Pod добавляют init-контейнер, который правилами iptables заворачивает исходящие соединения на порт 15001, а входящие — на 15006. Вручную это почти не пишут: в Istio достаточно пометить пространство имён istio-injection=enabled, и прокси с перенаправлением подставятся в Pod сами.
Цена — процесс Envoy на каждый Pod: триста подов — триста прокси со своей памятью, и обновление прокси — перезапуск каждого Pod. Плюс два прохода через прокси на каждый вызов: на выходе у вызывающего и на входе у вызываемого.
Не берут, когда все сервисы на одном языке: библиотека делает то же самое без лишнего процесса и лишних переходов.
Service Mesh: кто настраивает сто прокси
Sidecar решает задачу одного Pod. При пятидесяти сервисах прокси сотни, у каждого своя конфигурация: кому можно звать оплату, с каким тайм-аутом, каким сертификатом шифровать. Раздавать это руками — через месяц конфигурации разъедутся. Service Mesh — те же прокси плюс управляющий компонент, который раздаёт им конфигурацию и сертификаты из одного места: прокси в каждом Pod — data plane, через них идёт трафик; управляющий компонент, в Istio это istiod, — control plane, через него трафик не идёт.
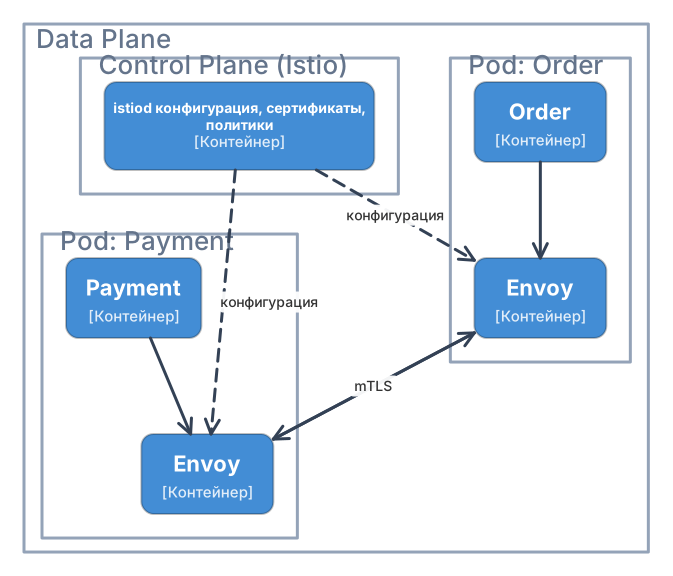
Стрелки от istiod к прокси — раздача конфигурации, трафик по ним не идёт; вызов заказов к оплате идёт только по нижней стрелке между двумя Envoy. Поэтому отказ istiod останавливает не трафик, а изменения и, через сутки, продление сертификатов.
apiVersion: networking.istio.io/v1
kind: VirtualService
metadata:
  name: order-service
spec:
  hosts:
    - order-service
  http:
    - route:
        - destination:
            host: order-service
            subset: v1
          weight: 80
        - destination:
            host: order-service
            subset: v2
          weight: 20
      retries:
        attempts: 3
        perTryTimeout: 2s
        retryOn: connect-failure,refused-stream
Один ресурс — и все прокси, вызывающие заказы, отдают пятую часть трафика новой версии и повторяют вызов при обрыве соединения; код сервисов не менялся. Ловушка: прокси не знает, что за запрос он повторяет. retryOn: 5xx заставит его повторить POST /payments, на который сервис ответил 503 уже после списания, — списание пройдёт дважды. Политика Istio по умолчанию — две попытки на обрыв соединения и на 503, без оглядки на метод, поэтому у маршрутов с неидемпотентными операциями повторы выключают (attempts: 0) или оставляют только на отказ соединения, как выше: соединение отвергнуто — запрос точно не выполнялся. Вторая ловушка — повторы умножаются: три попытки в прокси и три в Resilience4j внутри сервиса — девять запросов к лежащей оплате. Повтор живёт в одном месте; какие ошибки безопасно повторять — в паттернах отказоустойчивости.
Когда падает сам mesh, важно, какая половина. Прокси работают по последней полученной конфигурации, поэтому отказ istiod трафик не останавливает. Ломается новое: новые поды не получают прокси (вебхук внедрения по умолчанию не даёт создать Pod без своего ответа), изменения маршрутов не доезжают, а сертификаты mTLS в Istio живут сутки — лежит istiod дольше, и соединения отваливаются по истёкшему сертификату. Поэтому control plane резервируют и мониторят как базу.
Шлюз и mesh легко перепутать: оба «проксируют трафик». Разница — в направлении и в том, что каждый знает:
Шлюз знает, кто пользователь, и не видит ни одного вызова между сервисами; mesh видит каждый такой вызов и не знает, кто пользователь. Поэтому лимит на клиента и проверка токена живут на шлюзе, mTLS и тайм-ауты между сервисами — в mesh, и один другого не заменяет.
Не берут при десятке сервисов на одном языке: библиотека даёт те же повторы и тайм-ауты, а шифрование внутри закрытой сети требуют не всегда.
Service Discovery: где сейчас живёт экземпляр
Сервис заказов сегодня в трёх экземплярах, завтра в десяти; при каждом выкате адреса меняются, и в конфигурации вызывающего они устареют до конца выката. Подходов два: клиент сам спрашивает реестр и выбирает экземпляр — client-side discovery, так работают Eureka и Consul; или клиент зовёт одно постоянное имя, а за ним стоит балансировщик, который знает про экземпляры, — server-side, так работает Kubernetes Service.
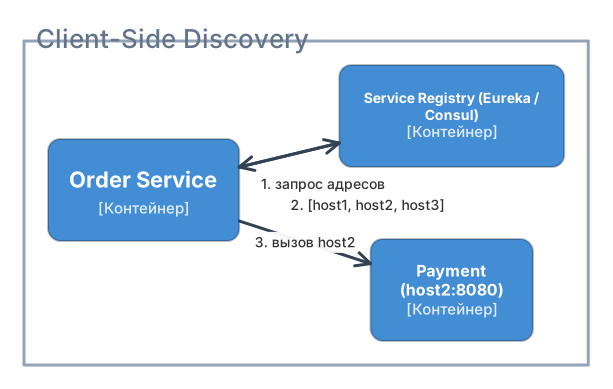
Экземпляр выбирает вызывающий по списку, который получил раньше: если host2 упал секунду назад, в списке он ещё есть, и вызов уйдёт в никуда. Насколько «раньше» — посчитано ниже.
В Spring Cloud с Eureka клиент зовёт сервис по имени — @FeignClient(name = "payment-service"), — а экземпляр выбирает балансировщик на стороне клиента.
Главная боль реестра — окно между падением экземпляра и моментом, когда об этом узнали все. Экземпляр шлёт сигнал раз в 30 секунд; реестр считает его живым, пока действует аренда в 90 секунд, причём из-за особенности расчёта в коде Eureka реальный срок — 180. Чистка реестра идёт раз в 60 секунд, ответ реестра кэшируется на сервере 30 секунд, клиент перечитывает реестр раз в 30 секунд, а балансировщик Spring Cloud держит список ещё 35. Всё это настройки по умолчанию, и в худшем случае они складываются в пять с половиной минут, в течение которых клиенты зовут адрес, на котором никого нет.
Интервалы не идут параллельно, а складываются: мёртвый адрес выпадает сначала из реестра, потом из кэша сервера, клиента и балансировщика. Пять с половиной минут — худший случай; обычный — две-три, и это тоже сотни неудачных вызовов при живом сервисе.
Уменьшать интервалы — путь в никуда: сотни экземпляров, сигналящие раз в 5 секунд, кладут сам реестр. Рабочий ответ — считать, что список всегда немного устарел: штатно снимаемый экземпляр сначала снимает себя с реестра и только потом останавливается, а на отвергнутое соединение вызывающий отвечает повтором на другой экземпляр — это быстрый отказ, он в бюджет влезает. Отдельная ловушка Eureka — режим самосохранения: если за 15 минут пришло меньше 85 % ожидаемых сигналов, реестр решает, что проблема в сети, а не в экземплярах, и перестаёт вычищать кого бы то ни было — при массовом падении он намеренно раздаёт мёртвые адреса.
В Kubernetes реестр встроен: Service получает DNS-имя, список живых подов собирается по readiness-пробе. Балансирует не DNS, а kube-proxy на каждом узле: правила iptables или IPVS раскидывают по подам новые соединения — именно соединения. HTTP/1.1 с коротким keep-alive распределяется ровно; gRPC и HTTP/2 держат одно долгоживущее соединение и гонят по нему все запросы — все уходят в один Pod, остальные девять простаивают. Лечится балансировкой на стороне клиента: gRPC-клиент умеет сам, если дать ему headless-Service с адресами подов вместо одного виртуального IP, — или прокси уровня HTTP, то есть mesh.
Вне Kubernetes реестр обязателен; внутри встроенного хватает, пока весь трафик — HTTP/1.1.
Strangler Fig: переезд с монолита по частям
Монолит работает, приносит деньги и обрастает задачами; переписать его целиком — год без новых функций и одна ночь переключения, после которой откатиться некуда. Вместо этого его разбирают по модулю: перед монолитом ставят шлюз, новый сервис получает один маршрут, монолит — всё остальное, и доля трафика на новых сервисах растёт, пока монолит не останется без работы. Название — по фикусу-душителю, который обвивает дерево и замещает его.
Доля переезжает по модулю: сначала вес маршрута заказов, потом заказы целиком, потом следующий модуль. Монолит обслуживает то, что не переехало, а строка внизу — самое трудное: данные переезжают позже трафика и своим планом.
spring:
  cloud:
    gateway:
      server:
        webflux:
          routes:
            - id: order-service
              uri: http://order-service:8080
              predicates:
                - Path=/api/orders/**
            - id: monolith
              uri: http://monolith:8080
              predicates:
                - Path=/api/**
              order: 9999
Маршрут монолита стоит последним по order: всё, для чего нет своего сервиса, уходит в него. Внутри монолита тот же переключатель — фасад с флагом, который зовёт либо старый класс, либо новый сервис по HTTP; флаг возвращает всё назад за минуту.
Самое трудное — данные: пока заказы наполовину в монолите, наполовину в новом сервисе, у них два хранилища, и отчёт «заказы за день» в монолите видит только свою половину. Вариантов три. Новый сервис первое время читает и пишет в базу монолита — просто, но связывает их схемой, и «своя база» откладывается. Старая сторона пишет в оба места, а ночная сверка ищет расхождения — работает при любой доле трафика, но двойную запись потом надо не забыть убрать. Или историю переносят один раз и переключают маршрут на 100 % с коротким окном без записи — честнее всего, но долю трафика уже не покрутить. Общее у всех трёх: ответы старого и нового сервиса сверяют до переключения — теневым трафиком, и только на чтении: повторить POST в оба места — создать заказ дважды.
Не берут для нового проекта — там нечего душить; и не трогают монолит, который работает и не мешает: переезд ради переезда — год без новых функций.
Anti-Corruption Layer: переводчик с чужого языка
Платёжный провайдер отдаёт txn_id, amount_cents и статус буквой S, F или P. Пустите эти имена в бизнес-логику — через год половина кода знает, что «S» значит успех, а смена провайдера превращается в переписывание половины сервиса. Слой-переводчик на границе принимает чужую модель и внутрь пропускает только свою.
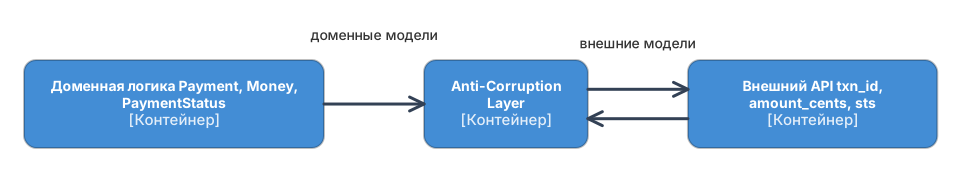
Справа от слоя живут txn_id и буквы статусов, слева — Payment и PaymentStatus. Замена провайдера меняет правую половину и сам переводчик, левая не замечает.
@Data
public class ExternalPaymentResponse {

    @JsonProperty("txn_id")
    private String txnId;

    @JsonProperty("amount_cents")
    private int amountCents;

    @JsonProperty("sts")
    private String sts;
}

public record Payment(UUID transactionId, Money amount, PaymentStatus status) {}

@Component
public class PaymentTranslator {

    public Payment toDomain(ExternalPaymentResponse external) {
        return new Payment(
            UUID.fromString(external.getTxnId()),
            Money.ofKopecks(external.getAmountCents()),
            switch (external.getSts()) {
                case "S" -> PaymentStatus.SUCCESS;
                case "F" -> PaymentStatus.FAILED;
                case "P" -> PaymentStatus.PENDING;
                default -> throw new IllegalArgumentException("Unknown status: " + external.getSts());
            });
    }
}
Чужие имена остаются в @JsonProperty, поля зовут по-человечески: от txn_id Lombok сделал бы геттер getTxn_id(). Но переименование — меньшая часть работы, настоящий перевод — понятий. У провайдера «транзакция» — одно списание, а у одного нашего платежа их может быть три: удержание, списание, возврат. Наш «платёж» — свёртка нескольких их txn; их статус P значит «мы ещё не знаем», у нас это отдельная ветка сценария с повторным опросом. Эти правила живут в переводчике, и больше нигде в сервисе слово txn не встречается.
Вторая работа слоя — ловить отказы внешней системы. Тайм-аут провайдера, его 502, его код ошибки E1042 переводятся здесь в семейство своих исключений — «провайдер недоступен», «платёж отклонён», — а выключатель и повторы из паттернов отказоустойчивости стоят на этом же слое: только он знает, что провайдерский 503 после списания повторять нельзя. Заменили провайдера — переписали переводчик, домен не заметил.
Не берут, когда внешняя модель и есть ваша, — редкий случай, и обычно он значит, что домен спроектировали по чужому API.
Глубже: разрезание данных: общая база, JOIN через границу и перенос историирасширенное
Strangler Fig выше переводит трафик, а самое трудное названо одной фразой: данные. Вот план по данным, потому что без него переезд останавливается на полпути, и сервисы годами живут с одной базой.
Общая база это не переходный этап, а антипаттерн, если у неё нет даты окончания. Пока два сервиса пишут в одну таблицу, у них общая схема, общие миграции и общие выкаты; это распределённый монолит с сетевыми задержками. Переходное состояние допустимо, но с правилом: у каждой таблицы назначен владелец, остальные переводятся в режим чтения, и это проверяется правами на уровне базы (GRANT SELECT без INSERT), а не договорённостью.
JOIN через границу исчезает, и заменяют его тремя способами по обстоятельствам. Для страницы «заказ с данными покупателя» новый сервис зовёт соседа по API или, чаще, держит у себя копию нужных полей покупателя (имя, email), обновляемую по событиям; копия это не дублирование, а производные данные, которые можно пересобрать. Для отчёта «продажи по регионам» соединение уезжает в аналитическое хранилище, куда оба сервиса отдают события. Для операции, которая обязана видеть обе стороны согласованно (списание со счёта под заказ), граница проведена неверно, и данные оставляют в одном сервисе.
Перенос истории. Существующие строки переливают со снимка в новую базу пакетами по ключу, запомнив позицию; дальше догоняют изменения через CDC или двойную запись. Двойная запись это приложение, которое на время переезда пишет в обе базы, и её делают через outbox, а не двумя INSERT подряд, иначе половина ошибок оставит базы разными. Порядок шагов, сверка контрольными суммами по диапазонам и переключение с откатом разобраны в статье про производные данные, раздел про переезд между хранилищами; здесь важно, что чтение переключают по доле трафика, а запись переносят последней, когда сверка неделю не находит расхождений.
Сверка после остаётся навсегда, а не только на переезд: фоновая задача сравнивает копии с источником правды по счётчикам и суммам за период и поднимает тревогу на расхождении, потому что события теряются, а копии расходятся тихо.
Порядок в целом: владелец у каждой таблицы, чтение соседей через API или копии, перелив и догон, сверка, перенос записи, удаление доступа к чужой базе. Последний шаг это тот, который откладывают навсегда, и именно он делает сервисы независимыми.
Глубже: сколько это стоит в людяхрасширенное
«Самый дорогой вариант» в развилке между монолитом и сервисами упирается не в железо, а в часы людей, и их считают по списку. Каждый сервис приносит с собой: репозиторий и конвейер сборки со всеми проверками; выкат с откатом; метрики, панели и сигналы тревоги; журнал и трассировку; дежурство и разбор инцидентов; обновление зависимостей и образов; контракт с версиями и его проверку; и то, о чём эта статья, шлюз, реестр, сетку, брокер, у каждого из которых своя эксплуатация.
Оценка снизу для команды: один инженер поддерживает в порядке два-три сервиса сверх основной работы, а каждая платформенная система (шлюз, сетка, реестр, брокер, Kubernetes) это от четверти до половины ставки постоянно, не на внедрение, а на жизнь. Команда из пяти человек с десятью сервисами, шлюзом, сеткой, брокером и кластером тратит на эксплуатацию больше, чем на продукт, и это арифметика, а не оценка их квалификации.
Из этого следует порядок внедрения. Сначала то, без чего сервисы не работают вовсе: конвейер, выкат, метрики и журнал, брокер, если есть события. Потом шлюз, когда клиентов больше одного типа. Сетка последней, когда сервисов десятки и mTLS и повторы руками стали дороже, чем её эксплуатация. И честный вариант для команды из пяти: модульный монолит с одним конвейером, одним выкатом и одной панелью, который отдаёт все плюсы границ без платы за сеть, о чём говорит развилка про монолит и микросервисы. Управляемые платформы в облаке снимают часть списка за деньги, но не снимают дежурство и разбор инцидентов, которые остаются вашими при любом варианте.
Коротко
- Каждый паттерн — компонент в эксплуатации; берут по одному под конкретную боль.
- Шлюз держится на двух условиях: входящий
X-User-Idзатирается до любых проверок, и мимо шлюза хода нет. Права на ресурс остаются в сервисе. - Шлюз — точка отказа, поэтому без состояния и в репликах; лимитер при отказе Redis пропускает всё.
- Агрегация собирает поля, BFF решает, что показать, и принадлежит команде клиента; бизнес-правило не живёт ни там, ни там.
- Sidecar даёт одно поведение любому языку ценой процесса на Pod; отказ control plane не останавливает трафик, но через сутки убивает mTLS. Повторы в прокси не знают про идемпотентность.
- Реестр всегда отстаёт: у Eureka по умолчанию до пяти с половиной минут мёртвого адреса. В Kubernetes kube-proxy балансирует соединения, и HTTP/2 уходит в один Pod.
- Strangler Fig — в первую очередь план по данным: общая база, двойная запись со сверкой или разовый перенос; сверка ответов — до переключения и только на чтении.
- ACL переводит понятия, а не имена полей, и ловит отказы внешней системы; повторы и выключатель стоят на нём.
- Данные при переезде: владелец у каждой таблицы с правами на уровне базы,
JOINчерез границу заменяют копией по событиям или аналитическим хранилищем, историю переливают со снимка с догоном через outbox, сверка остаётся навсегда, запись переносят последней. - Каждый сервис стоит конвейера, выката, панелей, дежурства и контракта; каждая платформенная система от четверти ставки постоянно; порядок внедрения: конвейер и наблюдаемость, потом брокер и шлюз, сетка последней.
Что пощупать
Backend for Frontend с параллельной сборкой экрана и лимитом частоты на общем счётчике в Redis — тринадцатый шаг практикума remodov/marketplace-system. Экран заказа лежит в трёх сервисах, и мобильный клиент получает его одной ручкой вместо трёх круговых задержек.
Сделаем сами
Ветка step-13-gateway-and-bff — сборка экрана и счётчик вынуты, два теста красные; Redis нужен настоящий, в этом весь смысл.
Что почитать дальше
- Паттерны отказоустойчивости — повторы, тайм-ауты и выключатель: что из этого ставить в прокси, что в код, и почему повтор после тайм-аута опасен.
- Распределённые паттерны — сага и outbox: что стоит вокруг каждого вызова, когда заказы уже переехали в свой сервис.
- Сеть Kubernetes — типы Service, readiness и endpoints, NetworkPolicy: как закрыть путь в обход шлюза.
- Монолит или микросервисы — нужно ли вообще разбивать, прежде чем ставить перед сервисами шлюз.