Пока заказ, оплата и склад живут в одной базе, за целостность отвечает одна команда @Transactional: либо заказ создан, деньги списаны и товар зарезервирован, либо не случилось ничего. Стоит разнести их по трём сервисам — и этой гарантии больше нет. У каждого сервиса своя база и свой процесс, чужую транзакцию откатить нечем, а сеть между ними рвётся в самый неудобный момент.
Откатить чужую транзакцию нечем: списанные 5 000 ₽ возвращает вторая операция, и пока она не прошла, система рассогласована. Отсюда всё остальное — компенсации в обратном порядке, идемпотентность и список пройденных шагов, переживающий перезапуск.
Почему не взять распределённую транзакцию
Первое, что приходит в голову, — протокол, который свяжет несколько баз в одну транзакцию. Он есть, ему сорок лет, он встроен в базы и брокеры — двухфазная фиксация, 2PC. Координатор ведёт участников через две фазы. Сначала спрашивает каждого «готов зафиксировать?» — участник выполняет всю работу, пишет её в журнал, блокирует затронутые строки и отвечает «да» или «нет». Потом, если все ответили «да», рассылает команду фиксировать; если хоть кто-то ответил «нет» — все откатываются.
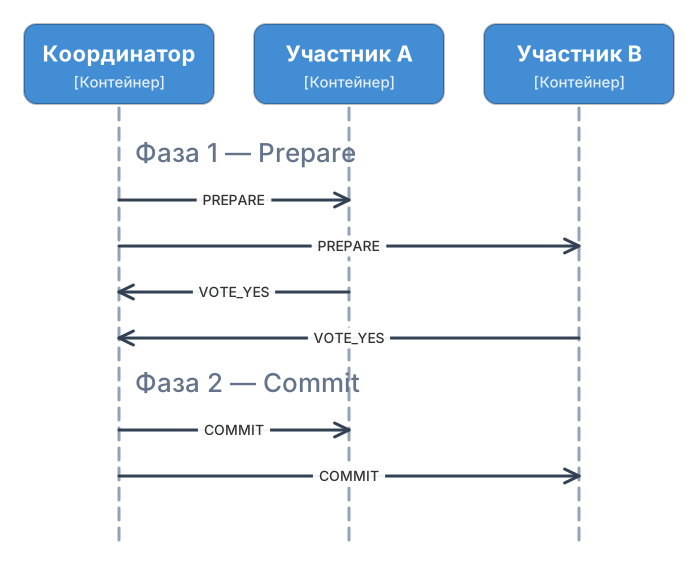
Между «да» участника и командой COMMIT его строки заблокированы. Пропал координатор — участник не может ни зафиксировать, ни откатить: он уже проголосовал «да» и обязан ждать решения, сколько бы оно ни шло.
Ломается это между «да» и командой: проголосовавший «да» участник не вправе передумать и держит строки заблокированными, пока ждёт решения. Пропал координатор — участники висят с блокировками в трёх базах, пока он не вернётся, и тайм-аут им не поможет: откатиться самостоятельно нельзя, вдруг координатор уже решил фиксировать. Добавьте два сетевых раунда на каждую транзакцию: при пяти участниках и десяти миллисекундах на вызов это плюс сто миллисекунд к каждому заказу.
Трёхфазный вариант (3PC) вставляет между фазами ещё одну, чтобы участники могли принять решение без координатора. Он дороже на раунд и не переживает разделения сети: участник, который получил предварительное «фиксируй» и потерял связь, зафиксирует, а участник по другую сторону разрыва откатится. Дальше учебников 3PC не пошёл.
Где 2PC уместен: несколько ресурсов в одной инфраструктуре под общим менеджером транзакций — база и брокер, причём разных производителей; стандарт XA ровно для этого и написан. Между сервисами по сети его не берут.
Сага: цепочка шагов, у каждого из которых есть отмена
Раз общей транзакции нет, остаётся признать: три шага — это три локальные транзакции, и каждая фиксируется сама. Тогда отказ третьего шага не откатывает первые два — их отменяют своими руками, отдельными операциями в обратном порядке. Такая цепочка и называется сагой: у каждого прямого шага есть парная компенсация.
| Прямой шаг | Компенсация |
|---|---|
| создать заказ | отменить заказ |
| списать деньги | вернуть деньги |
| зарезервировать на складе | снять резерв |
Пока сага идёт, система рассогласована: заказ создан, деньги списаны, резерва нет. Это не ошибка, а свойство — согласованность наступает в конце, а не в каждый момент, eventual consistency. Из него следуют три правила.
Промежуточное состояние видно снаружи, поэтому на время саги заказ стоит в статусе PENDING: иначе доставка увидит «оплачен» и отгрузит, а через секунду сага откатит оплату. Такой статус называют семантической блокировкой — строку он не запирает, а предупреждает остальных, что читать её как готовую нельзя.
Не каждый шаг отменяем: письмо «заказ подтверждён» не отзовёшь, выехавшего курьера не вернёшь. Такой шаг — точка невозврата, и его ставят последним: всё до него компенсируется, всё после обязано доехать — повторяться до успеха, а не откатываться. Два неотменяемых шага в одной цепочке означают, что между ними откатить сагу честно нельзя, и резать её надо иначе.
Компенсация может не пройти — шлюз не отвечает, склад лежит. Её не отменяют, а повторяют до успеха, и для этого сага обязана помнить, где остановилась.
Оркестратор: журнал шагов обязан пережить перезапуск
Оркестратор — компонент, который знает порядок шагов и какую компенсацию вызвать при отказе. Самое важное в нём не цикл по шагам, а строка в таблице sagas: какая сага идёт, какой шаг пройден, в какую сторону она движется. Живи этот список только в памяти, падение процесса между вторым и третьим шагом оставит деньги списанными навсегда: после перезапуска сервис не знает, что сага вообще была.
public class CreateOrderSaga {

    private final List<SagaStep<SagaContext>> steps = List.of(
        new SagaStep<>("create-order",
            c -> orderService.create(c.getRequest()),
            c -> orderService.cancel(c.getOrderId())),
        new SagaStep<>("charge-payment",
            c -> paymentService.charge(c.sagaId(), c.getUserId(), c.getTotal()),
            c -> paymentService.refund(c.getPaymentId())),
        new SagaStep<>("reserve-inventory",
            c -> inventoryService.reserve(c.getOrderId(), c.getItems()),
            c -> inventoryService.releaseReservation(c.getOrderId())));

    public OrderResult execute(CreateOrderRequest request) {
        SagaContext ctx = sagaLog.start(request);
        return run(ctx, 0);
    }

    private OrderResult run(SagaContext ctx, int from) {
        for (int i = from; i < steps.size(); i++) {
            try {
                ctx.apply(steps.get(i).action().apply(ctx));
                sagaLog.stepCompleted(ctx.sagaId(), i, ctx);
            } catch (Exception e) {
                sagaLog.compensating(ctx.sagaId(), i);
                compensate(ctx, i);
                throw new SagaException("Step failed: " + steps.get(i).name(), e);
            }
        }
        sagaLog.completed(ctx.sagaId());
        return ctx.toResult();
    }

    private void compensate(SagaContext ctx, int failedAt) {
        for (int i = failedAt - 1; i >= 0; i--) {
            steps.get(i).compensation().accept(ctx);
            sagaLog.stepCompensated(ctx.sagaId(), i);
        }
        sagaLog.compensated(ctx.sagaId());
    }
}
Каждый вызов sagaLog — отдельная короткая транзакция в базе оркестратора: строка sagas со статусом RUNNING, COMPENSATING, COMPLETED или COMPENSATED, номером текущего шага, контекстом в jsonb и временем последнего движения. Раз в минуту сервис забирает саги, которые не двигались дольше пяти минут, и доигрывает их с того шага, на котором остановился журнал: незавершённую — вперёд, компенсирующуюся — назад.
@Scheduled(fixedDelay = 60_000)
public void resumeStuck() {
    for (SagaRecord saga : sagaLog.claimStuck(Duration.ofMinutes(5), 10)) {
        try {
            switch (saga.status()) {
                case RUNNING      -> run(saga.context(), saga.currentStep());
                case COMPENSATING -> compensate(saga.context(), saga.currentStep());
            }
        } catch (Exception e) {
            sagaLog.attemptFailed(saga.id());
        }
    }
}
В подхвате три ловушки. «Не двигалась пять минут» не значит «умерла»: сага может ещё идти на медленном экземпляре, и подхват выполнит её шаг второй раз. Поэтому claimStuck захватывает строки через FOR UPDATE SKIP LOCKED с арендой, как relay ниже, а прямые шаги идут с ключом sagaId: повторный charge с тем же ключом сервис оплаты узнает и не спишет.
Второй аргумент claimStuck — предел попыток: после десяти неудачных подхватов сага уходит в FAILED и в оповещение, потому что компенсация, не прошедшая десять раз, — уже не сбой сети, а деньги, которые возвращают другим путём. И самое частое — падение посреди компенсации: refund вызван, деньги ушли, отметить шаг не успели. После перезапуска refund вызовется снова и вернёт ещё 5 000 ₽, если сам не проверит, что платёж уже возвращён.
Хореография: те же шаги без центра
Второй способ — не заводить того, кто знает порядок: каждый сервис слушает событие соседа и публикует своё. Заказ создан — оплата списывает и сообщает, склад слышит про оплату и резервирует.
@KafkaListener(topics = "order-events")
@Transactional
public void onOrderCreated(OrderCreatedEvent event) {
    try {
        PaymentResult result = paymentService.charge(event.userId(), event.total());
        outboxPublisher.save("Order", event.orderId(),
            "PaymentCharged", new PaymentChargedPayload(result.paymentId()));
    } catch (PaymentDeclinedException declined) {
        outboxPublisher.save("Order", event.orderId(),
            "PaymentFailed", new PaymentFailedPayload(declined.getMessage()));
    }
}
Две вещи, на которых здесь спотыкаются. Ответное событие уходит через outbox, о котором ниже, а не прямым вызовом брокера: лежит брокер — событие пропадёт, сдвиг прочитанного зафиксируется, и сага замрёт навсегда, потому что её продолжения никто не ждёт. И ловим только отказ в оплате: «карта отклонена» — ответ бизнеса, о нём саге надо сообщить. Недоступность шлюза ответом не является — исключение летит наружу, сдвиг не фиксируется, сообщение придёт ещё раз.
Что выбрать: оркестратор или события
Слева порядок шагов и все компенсации знает один компонент, и застрявшую сагу находят по одной строке. Справа порядок нигде не записан, он складывается из подписок, — и у отказа склада уже два адресата: каждый обязан подписаться на InventoryFailed сам и ничего не забыть.
Хореография хороша, пока цепочка коротка и линейна: два-три шага, у отказа один адресат, сервисы делают разные команды и ценят независимость. Четыре шага и больше, ветвление («частичная оплата — другой путь») или вопрос «в каком состоянии заказ прямо сейчас» — берут оркестратор. Верный признак, что пора: чтобы понять, что случится после события, приходится читать подписки в трёх репозиториях.
Компенсация — новая операция, и она обязана быть идемпотентной
refund() не откатывает списание: списание уже зафиксировано, и в выписке будут две строки, −5 000 и +5 000. Это отдельная бизнес-операция со своей транзакцией. И раз оркестратор после перезапуска вызовет её второй раз, два вызова обязаны дать один возврат.
public void refund(String paymentId) {
    Payment payment = paymentRepository.findById(paymentId).orElseThrow();
    if (payment.getStatus() == PaymentStatus.REFUNDED) {
        return;
    }
    paymentGateway.refund(payment.getGatewayId(), paymentId);
    payment.markRefunded();
    paymentRepository.save(payment);
}
Проверка статуса — защита от «10 000 вместо 5 000», но с дырой: процесс может упасть между paymentGateway.refund и markRefunded, и следующий вызов увидит CHARGED. Дыру закрывает второй аргумент: paymentId уходит в шлюз ключом идемпотентности, и повтор с тем же ключом шлюз не проводит. У платёжных API такой ключ есть всегда; компенсация без него надёжна до первого падения между двумя строками.
Transactional Outbox: событие в той же транзакции, что и данные
Заказ сохранён, о нём надо сообщить остальным — и самый очевидный код такой:
// так не надо
orderRepository.save(order);
kafka.send(new OrderCreatedEvent(order));
Между этими строками процесс может упасть: заказ есть, события нет, оплата про заказ не узнает никогда. Перенести отправку внутрь транзакции не лучше: событие уйдёт, транзакция откатится — оплата спишет деньги за заказ, которого нет. База и брокер — две системы без общей транзакции, та же задача, что и вся статья.
Выход — не писать в две системы: событие сохраняется в той же транзакции, что и заказ, в таблицу outbox_events, а брокера в транзакции нет вообще. Отдельный фоновый процесс, relay, читает таблицу и публикует накопившееся.
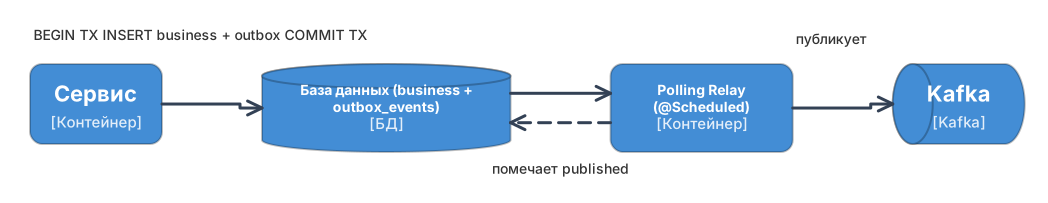
Сеть в транзакции не участвует: Kafka видит только relay, а relay идёт в неё уже после фиксации. Поэтому событие не может ни потеряться, ни уйти от откатившейся транзакции — но может уйти дважды.
CREATE TABLE outbox_events (
    id             bigint      GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    event_id       uuid        NOT NULL DEFAULT gen_random_uuid(),
    aggregate_type text        NOT NULL,
    aggregate_id   text        NOT NULL,
    event_type     text        NOT NULL,
    payload        jsonb       NOT NULL,
    created_at     timestamptz NOT NULL DEFAULT now(),
    claimed_until  timestamptz,
    published_at   timestamptz,
    retry_count    int         NOT NULL DEFAULT 0
);

CREATE INDEX outbox_events_pending_idx
    ON outbox_events (id) WHERE published_at IS NULL;

DELETE FROM outbox_events
WHERE published_at IS NOT NULL
  AND published_at < now() - INTERVAL '7 days';
Два поля здесь не случайны. id — растущий счётчик, а не uuid: по нему relay читает события в порядке записи, у случайного ключа порядка нет. event_id — отдельный, он уедет в сообщение и станет ключом дедупликации у приёмника. Частичный индекс по неопубликованным нужен, потому что relay опрашивает таблицу дважды в секунду: при тысяче событий в минуту за неделю в ней десять миллионов опубликованных строк, и без индекса каждый опрос читал бы их все.
@Transactional
public Order createOrder(CreateOrderCommand cmd) {
    Order order = orderRepository.save(newOrder(cmd));
    outboxPublisher.save("Order", order.getId().toString(),
        "OrderCreated", new OrderCreatedPayload(order));
    return order;
}

@Scheduled(fixedDelay = 500)
public void publishPending() {
    for (OutboxEvent event : outboxService.claimBatch(100)) {
        try {
            kafka.send(topic(event), event.getAggregateId(), event.getPayload())
                 .get(5, TimeUnit.SECONDS);
            outboxService.markPublished(event.getId());
        } catch (Exception e) {
            outboxService.markFailed(event.getId());
        }
    }
}
@Transactional
public List<OutboxEvent> claimBatch(int size) {
    List<OutboxEvent> events = outboxRepository.findPendingForUpdateSkipLocked(size);
    Instant until = Instant.now().plus(Duration.ofMinutes(10));
    events.forEach(e -> e.claimUntil(until));
    return outboxRepository.saveAll(events);
}
У relay три вида транзакций, все короткие: взять пачку, отметить отправленное, отметить неудачу. Отправка в Kafka стоит между ними, а не внутри: send(...).get() — поход по сети, и пока он идёт, транзакция держала бы соединение с базой и заблокированные строки, а один притормозивший брокер превращался бы в очередь из ждущих соединений. По той же причине у .get() тайм-аут. Методы claimBatch и markPublished живут в отдельном бине OutboxService: вызов @Transactional-метода изнутри того же класса прокси не перехватит.
FOR UPDATE SKIP LOCKED нужен при нескольких экземплярах: каждый забирает свою пачку, одно событие не достаётся двоим. Аренда claimed_until — на случай, если relay умрёт с пачкой в руках: по истечении срока события подберёт другой. С числом легко ошибиться: аренда обязана быть длиннее худшего времени отправки пачки, а это сто событий по тайм-ауту 5 секунд — 500 секунд. Аренда в 30 секунд на плохой сети истечёт посреди отправки, и второй relay отправит те же события ещё раз. Отсюда десять минут; цена — пачка умершего relay ждёт до десяти минут, и если это много, режут пачку, а не аренду.
Порядок событий: что ломает второй relay
С двумя relay показанный код не гарантирует порядок. У заказа 42 в outbox лежат OrderCreated и следом OrderCancelled; первый relay забрал первое, второй — второе и оказался быстрее. Kafka хранит порядок внутри партиции, но тот, в котором сообщения пришли от отправителя, — а пришли они наоборот. Потребитель видит отмену несуществующего заказа, потом создание — и заказ воскресает.
Лечат тремя способами, по возрастанию цены. Один relay на таблицу: опрос делает тот экземпляр, что держит блокировку задания (ShedLock или советующая блокировка PostgreSQL), — при тысяче событий в минуту его хватает с запасом. Разделить таблицу по агрегату: экземпляр забирает строки, у которых hash(aggregate_id) % n равен его номеру, и события одного заказа идут через один relay. Или научить потребителя переставленным событиям: у события есть номер версии внутри агрегата, всё не больше виденного молча пропускается — так устроены проекции в Event Sourcing.
«Хотя бы раз»: почему приёмник обязан гасить дубли
Relay может упасть после send, но до markPublished: событие уже в брокере, строка не помечена, при следующем опросе оно уйдёт снова. Так outbox устроен намеренно — потерять событие нельзя, отправить дважды можно. Это at-least-once, «хотя бы раз», единственная гарантия, возможная без общей транзакции между базой и брокером. Следствие: у каждого потребителя своя защита от повтора, о ней следующий раздел.
Polling или CDC
Вместо опроса таблицы её изменения можно читать из журнала базы (WAL) внешним коннектором, который сам пишет в Kafka, — это Change Data Capture, в промышленном виде Debezium с маршрутизатором outbox-событий. Контракт тот же: Debezium читает ту же таблицу outbox_events и отдаёт тот же payload. Разница в эксплуатации: CDC — отдельный кластер и, как правило, отдельные люди, polling живёт в вашем сервисе и катится с ним.
Застрявший коннектор не даёт базе выбросить прочитанный WAL, и кончается диск; у застрявшего polling пухнет outbox_events. Зато CDC читает журнал одним читателем в порядке фиксации, и вопроса порядка у него нет. Берут его, когда событий столько, что опрос заметно грузит базу — десятки тысяч в секунду, — или когда поток изменений нужен не только вам.
Idempotent Consumer: приёмник, который гасит дубли сам
Одно и то же событие приходит потребителю не один раз, и не только из-за relay: брокер повторяет недоставленное, при перебалансировке группы часть сообщений перечитывается, сдвиг фиксируется после обработки и может не успеть. Обработать «заказ создан» дважды — списать с покупателя дважды.
Защита — таблица обработанных событий, но порядок действий важнее самой таблицы. Напрашивается «проверить, и если не обрабатывали — обработать»; с двумя экземплярами это не работает: оба видят «отметки нет», оба выполняют работу. Правильный порядок — сначала вставить отметку, потом работать: вставку одновременно сделает один, второй споткнётся об уникальный индекс.
Проверка перед работой не защищает: между «отметки нет» и «вставил отметку» второй экземпляр успевает увидеть то же самое. Вставка первой — это проверка и отметка одним действием, и спор двоих решает уникальный индекс, а не код.
Споткнуться второй обязан мягко. Если ловить DataIntegrityViolationException и продолжать в той же транзакции, ничего не выйдет: после нарушения ограничения транзакция уже помечена «только откат», и коммит упадёт с UnexpectedRollbackException. Поэтому вставка идёт через ON CONFLICT DO NOTHING — при дубле она не бросает исключение, а возвращает ноль строк.
@Modifying
@Query(value = "INSERT INTO processed_events (event_id, processed_at) "
             + "VALUES (:eventId, :processedAt) ON CONFLICT (event_id) DO NOTHING",
       nativeQuery = true)
int insertIfAbsent(@Param("eventId") String eventId, @Param("processedAt") Instant processedAt);

@Transactional
public <T> void process(String eventId, Supplier<T> handler) {
    if (processedEvents.insertIfAbsent(eventId, Instant.now()) == 0) {
        return;
    }
    handler.get();
}

@KafkaListener(topics = "payment-events")
public void onPaymentCharged(PaymentChargedEvent event) {
    idempotentProcessor.process(event.eventId(), () -> {
        Order order = orderRepository.findById(event.orderId()).orElseThrow();
        order.markPaid(event.paymentId());
        orderRepository.save(order);
        return null;
    });
}
CREATE TABLE processed_events (
    event_id     text        PRIMARY KEY,
    processed_at timestamptz NOT NULL DEFAULT now()
);

DELETE FROM processed_events
WHERE processed_at < now() - INTERVAL '7 days';
Отметка и работа — в одной транзакции: упала обработка, откатилась и отметка, событие придёт снова. Срок хранения отметок обязан быть длиннее срока, за который брокер способен отдать событие повторно: у Kafka это время хранения топика, по умолчанию как раз семь дней; хранит топик месяц или сообщения возвращают из очереди мёртвых писем спустя недели — отметки чистят не раньше.
Для HTTP то же: клиент присылает заголовок Idempotency-Key, сервер вставляет его в таблицу с уникальным индексом до выполнения запроса, а при повторе отдаёт сохранённый ответ первой попытки. Почему дедупликация стоит именно на приёмнике, а не в брокере и не в TCP, — в статье про корректность распределённых систем.
Блокировка: когда она нужна, а когда хватает уникального индекса
Два экземпляра одновременно обрабатывают один заказ, и покупатель платит дважды. Первый рефлекс — «нужна распределённая блокировка», но сначала стоит спросить, почему их двое. Если один запрос или одно сообщение пришли дважды, блокировка не спасает: второй экземпляр дождётся, пока первый отпустит, и спишет ещё раз. От повтора защищает ключ операции и уникальный индекс — отметка из прошлого раздела или request_id клиента. Блокировка защищает от другого: от двух разных действий над одним ресурсом в один момент.
Если ресурс — строка в вашей базе, блокировка уже есть, и это SELECT ... FOR UPDATE: второй экземпляр ждёт транзакцию первого, а потом видит уже изменённый статус. Ничего не истекает и не теряется, потому что блокировка живёт и умирает вместе с транзакцией.
@Transactional
public void confirmOrder(Long orderId) {
    Order order = orderRepository.findByIdForUpdate(orderId).orElseThrow();
    if (order.getStatus() == OrderStatus.CONFIRMED) {
        return;
    }
    order.confirm();
    orderRepository.save(order);
}

public Optional<Order> findByIdForUpdate(Long id) {
    return dsl.selectFrom(ORDERS)
        .where(ORDERS.ID.eq(id))
        .forUpdate()
        .fetchOptional()
        .map(mapper::toDomainOrder);
}
Внешняя блокировка нужна ресурсу вне базы: вызов внешнего API, который нельзя делать параллельно, файл, ночной пересчёт на одном экземпляре из трёх. Для заданий по расписанию это ShedLock, для остального — блокировка в Redis через Redisson.
public <T> T executeWithLock(String lockKey, Duration leaseTime, Supplier<T> action) {
    RLock lock = redisson.getLock(lockKey);
    boolean acquired;
    try {
        acquired = lock.tryLock(2, leaseTime.toSeconds(), TimeUnit.SECONDS);
    } catch (InterruptedException e) {
        Thread.currentThread().interrupt();
        throw new LockAcquisitionException("Interrupted while acquiring: " + lockKey, e);
    }
    if (!acquired) {
        throw new LockAcquisitionException("Cannot acquire lock: " + lockKey);
    }
    try {
        return action.get();
    } finally {
        if (lock.isHeldByCurrentThread()) {
            lock.unlock();
        }
    }
}
Два числа в tryLock — про разное. Первое, 2 секунды, — сколько ждать саму блокировку: в потоке, обслуживающем запрос, дольше нельзя — при двухстах потоках и сорока запросах в секунду пул кончится за пять секунд ожидания. Второе — на сколько блокировка выдаётся, то есть сколько отводится работе; без срока упавший процесс держал бы её вечно. Взаимную блокировку — два процесса берут два ресурса в разном порядке и ждут друг друга — лечат одним правилом: брать всегда в одном порядке, например по возрастанию идентификатора.
Почему блокировка не гарантирует единственного владельца
Срок аренды защищает от упавшего процесса — и он же создаёт второго владельца. Работа заняла дольше аренды: поток встал в паузу сборщика мусора на сорок секунд при аренде в тридцать, блокировка истекла, её взял другой экземпляр, а первый, очнувшись, уверен, что она его, и пишет. То же при переезде Redis на нового мастера, пока жив старый. Настройками Redis это не чинится, даже вариантом с несколькими независимыми узлами: клиент, который считает себя в порядке, и есть источник проблемы.
Единственная защита — маркер с номером: вместе с блокировкой выдаётся постоянно растущий номер, клиент прикладывает его к каждой записи, а хранилище отвергает запись с номером меньше уже виденного. Проверяет маркер сам ресурс, не клиент, — и опоздавший владелец ничего не портит. Как двое становятся владельцами одной блокировки и как маркер отсекает опоздавшего — по тактам, с числами — в анимации в статье про проблемы распределённых систем.
Пока A стоял на паузе, аренду успел взять B, и отличить бывшего владельца от текущего может только номер маркера в записи.
Event Sourcing: когда поток событий и есть хранилище
Outbox кладёт событие рядом с состоянием ради доставки. Обратный способ — не хранить состояние вовсе: только события, OrderCreated, PaymentReceived, OrderConfirmed, а текущий заказ собирать, проигрывая их с начала. Тогда outbox не нужен: поток событий и есть таблица, из которой публикует relay. Версия агрегата с уникальным индексом по паре «поток, номер» защищает от одновременной дозаписи, снапшоты — от проигрывания тысяч событий, проекции дают быстрые таблицы чтения в паре с CQRS. Берут это ради полной истории — финансы, расчёты с продавцами, аудит; для справочников и CRUD это дорого и не нужно. Устройство целиком — в статье про Event Sourcing.
Когда всё это не нужно
Сага нужна, когда шаги лежат в разных базах. Два шага в одном сервисе — одна транзакция; сага здесь добавляет таблицу sagas, подхват и компенсации, которые никогда не сработают. Сага на один внешний вызов — не сага, а повтор с тайм-аутом из паттернов устойчивости.
Outbox нужен, когда событие нельзя восстановить из состояния. Если потребителю хватает прочитать текущую строку заказа, outbox_events и relay добавляют только место и опрос; outbox берут там, где важен сам факт перехода — «оплачен в 12:03», а не «сейчас оплачен».
Блокировка нужна ресурсу вне базы; всё, что лежит в вашей таблице, защищают FOR UPDATE и уникальный индекс. Event Sourcing нужен, когда есть кто-то, кто будет читать историю, — а не «может пригодиться».
Как это проверить тестами
Каждый приём держится на поведении при сбое, поэтому тесты пишут на сбой в нужной точке, а не на успешный путь, и гоняют против настоящего PostgreSQL в контейнере: ON CONFLICT, SKIP LOCKED и FOR UPDATE встроенная база в памяти ведёт иначе.
Сага: третий шаг подменён заглушкой, которая бросает исключение, — компенсации первых двух вызваны в обратном порядке, строка sagas стоит в COMPENSATED. Перезапуск: заглушка бросает после refund, но до отметки шага, затем вызывается resumeStuck — refund в шлюз уходит один раз, не два; этот тест краснеет ровно на дыре из раздела о компенсациях.
Приёмник: отдать обработчику одно событие дважды подряд — одна строка в processed_events, одно списание. Затем то же событие из двух потоков одновременно — и снова одно списание: это единственный тест, который отличает «сначала отметка» от «сначала проверка».
Relay: markPublished падает после успешного send — событие уходит повторно, и приёмник его гасит. Два потока зовут claimBatch на одной таблице — пачки не пересекаются; тот же вызов после истечения аренды — события подобраны.
Как паттерны работают вместе
Гарантии «ровно один раз» нет ни в одном звене: каждое отдаёт «хотя бы раз». Ровно один раз получается потому, что на каждом приёмнике стоит своя отметка — таблица processed_events у потребителя, статус платежа у возврата, журнал шагов у саги.
OrderService в одной транзакции пишет заказ со статусом PENDING и событие в outbox; relay под арендой публикует его в Kafka; PaymentService вставляет отметку, списывает и через свой outbox отвечает PaymentCharged; оркестратор отмечает шаг в sagas и зовёт склад. Склад отказал — сага переходит в COMPENSATING, refund проверяет статус платежа и уходит в шлюз с ключом paymentId, потом отменяется заказ. Упади процесс в любой точке — подхват доиграет сагу с последнего отмеченного шага, повторные вызовы упрутся в отметки, итог тот же. Блокировки в цепочке нет ни одной: всё, что могло столкнуться, столкнулось с уникальным индексом.
Глубже: порядок событий: ключ партиции, опоздавшие и время событиярасширенное
Сага и outbox молчаливо предполагают, что события приходят по порядку. В брокере с партициями порядок держится только внутри одной партиции, и «заказ оплачен» может прийти раньше «заказ создан», если они попали в разные. Три перевозчика, три партиции, статусы одной посылки вперемешку: это не сбой, а устройство.
Ключ партиции это решение о порядке. Все события одного объекта обязаны идти с одним ключом, идентификатором заказа или посылки, тогда они ложатся в одну партицию и доезжают по порядку; ключ «перевозчик» или «тип события» разводит события одного заказа по разным партициям и ломает порядок именно там, где он нужен. Цена: горячий ключ (крупный клиент) занимает одну партицию, и её нельзя ускорить числом потребителей, о чём статья про основы Kafka.
События вне очереди всё равно бывают: после переразбиения топика, при повторной отправке, при слиянии из двух источников. Потребитель не полагается на порядок прихода, а проверяет версию: у каждого события номер по объекту (version), потребитель применяет событие, только если оно следующее за сохранённой версией, событие с меньшим номером отбрасывает как повтор, с большим откладывает или запрашивает пропущенное.
Для статусов это автомат переходов: «доставлен» из «создан» допустим, «в пути» после «доставлен» игнорируется. Вариант проще, когда порядок не важен по существу: события несут не «что изменилось», а «какое состояние сейчас» вместе с временем, и потребитель принимает более позднее по времени события.
Время события против времени получения. Отметка в событии ставится там, где оно произошло, и именно по ней принимают решения: окно «за час», «какое состояние последнее», «опоздало или нет». Время получения зависит от очередей и повторов и ничего не говорит о порядке в мире. Опоздавшее событие (пришло после того, как окно закрыто или состояние ушло дальше) либо применяется как поправка с записью в журнал, либо отбрасывается с метрикой доли опоздавших, и это осознанный выбор для каждого потребителя, о чём подробно статья про потоковую обработку с водяными знаками.
Итог для проектирования: ключ по объекту, версия в событии, автомат состояний у потребителя, время события в теле. С этими четырьмя порядок партиции становится удобством, а не условием корректности.
Глубже: тесты распределённой системы: контракт, идемпотентность, падение посреди саги, намеренные отказырасширенное
Раздел про проверку тестами короток, а именно тесты отличают паттерн, который работает, от паттерна, который нарисован. Четыре вида, по возрастанию цены.
Контрактные тесты. Событие, которое публикует сага, и ответ, который читает следующий шаг, это контракты, и их ломают чаще, чем код. Схема события в репозитории со сравнением в сборке и тест потребителя, который читает пример события из схемы, ловят это без брокера. Для вызовов по API то же делает Pact, о чём статья про API-first.
Идемпотентность потребителя. Тест отправляет одно и то же событие дважды и трижды, включая вариант «дважды подряд в двух потоках», и проверяет, что действие произошло один раз, а отметка одна. Это тест на базе с настоящей уникальностью, а не на заглушке репозитория, потому что защита живёт в индексе.
Падение посреди саги. Самый ценный и самый редкий тест: шаг два выполнен, шаг три бросает исключение, и проверяется, что компенсация шага два вызвана, состояние саги записано, а повторный запуск с того же места не повторяет шаг два. Делается подменой одного участника на заглушку, которая падает по условию, и прогоном оркестратора на настоящей базе. Вторая версия того же теста: падение между записью в базу и отправкой события, где спасает outbox, и тест проверяет, что событие всё-таки ушло после перезапуска отправителя.
Намеренные отказы. На стенде с настоящими сервисами останавливают сервис оплаты посреди нагрузки, режут сеть до брокера, задерживают ответы на пять секунд (Toxiproxy умеет и то, и другое из теста), и смотрят, что таймауты, повторы и выключатели из статьи про отказоустойчивость ведут себя как обещано, а сага доходит до конца или до компенсации. Это не постоянная практика хаос-инженерии, а один прогон перед выпуском, который находит бесконечное ожидание и повтор неидемпотентного шага.
Что не тестируют: работу брокера и базы (это их тесты) и «всю систему целиком на каждый коммит», что дорого и медленно. Четыре вида выше запускаются в CI сервиса, кроме последнего, который живёт в отдельном конвейере перед выпуском.
Коротко
- Общей транзакции между сервисами нет: 2PC держит чужие блокировки, пока жив координатор; между сервисами берут сагу.
- Сага держится на журнале в базе, не на цикле в памяти: без строки
sagasупавший процесс оставляет деньги списанными навсегда. Неотменяемый шаг — последним; застрявшую сагу подхватывают с арендой и пределом попыток. - Компенсацию вызовут дважды: проверка статуса в её транзакции плюс ключ идемпотентности в шлюз — то, что отличает 5 000 от 10 000.
- Outbox убирает двойную запись, но не дубли: relay доставляет «хотя бы раз», при нескольких relay порядок не гарантирован, аренда длиннее худшей пачки.
- Дубль гасит приёмник, не брокер: сначала
INSERTотметки, потом работа; отметки живут дольше, чем брокер способен повторить. - От повтора — ключ и уникальный индекс, от одновременности в своей базе —
FOR UPDATE; Redis-блокировка нужна ресурсу вне базы и без маркера второго владельца не исключает. - Два шага в одном сервисе — транзакция, не сага; событие, восстановимое из состояния, не требует outbox.
- Порядок событий держится только внутри партиции: ключ по объекту, версия в событии и автомат переходов у потребителя, время события в теле, опоздавшие как поправка или с метрикой отбрасывания.
- Тесты: контракт события в сборке, идемпотентность на настоящей уникальности, падение посреди саги с проверкой компенсации и повторного запуска, намеренные отказы через Toxiproxy перед выпуском.
Что пощупать
Outbox, идемпотентный потребитель, ключ идемпотентности команды и компенсация в практикуме remodov/marketplace-system — не четыре слайда, а четыре куска сервиса заказов, которые тесты проверяют настоящим HTTP и настоящей базой. Шаги 9–11.
Код: usecase/command, adapter-out-postgres.
Сделаем сами
Ветки step-09-idempotency, step-10-events-and-contract, step-11-saga-and-state-machine.
Что почитать дальше
- Event Sourcing — версия агрегата, снапшоты и проекции, которые здесь только упомянуты.
- Корректность в распределённой системе — почему «ровно один раз» — сквозной ключ на приёмнике, а не настройка брокера.
- Проблемы распределённых систем — анимация: два владельца одной блокировки и маркер, который проверяет хранилище.
- Паттерны устойчивости — тайм-ауты, повторы и размыкатель вокруг каждого шага саги и каждой отправки relay.