Когда сервисов в системе становится больше одного, им нужно обмениваться событиями. Kafka — один из самых распространённых инструментов для этого. Разберём с нуля: зачем она нужна, как работает и где подводные камни.
Сразу общая картина: топик разбит на партиции, и ключ сообщения решает, в какую из них попадёт событие, — а от этого зависит порядок, в котором события прочитают.
Ключ решает, в какую партицию попадёт событие. Без ключа четыре события одного заказа разъехались по двум партициям, их читают два разных потребителя — и shipped обрабатывается раньше paid. С ключом orderId все четыре лежат в P1, а партицию в группе читает ровно один потребитель — порядок сохраняется.
Проблема: сервисы связаны напрямую
Представьте: пользователь оформляет заказ. OrderService должен уведомить PaymentService, InventoryService и NotificationService. Самый простой вариант — HTTP-вызовы напрямую.
Но у этого подхода есть проблема: если PaymentService недоступен, OrderService тоже не может завершить работу. Один падающий сервис тянет за собой другие. Это называют синхронной связностью — сервисы зависят друг от друга в реальном времени.
Kafka решает это иначе. Это распределённый лог сообщений: OrderService записывает событие «заказ создан», а все заинтересованные сервисы читают его самостоятельно — каждый в своём темпе. Если NotificationService временно упал, он просто догонит пропущенные события после перезапуска.
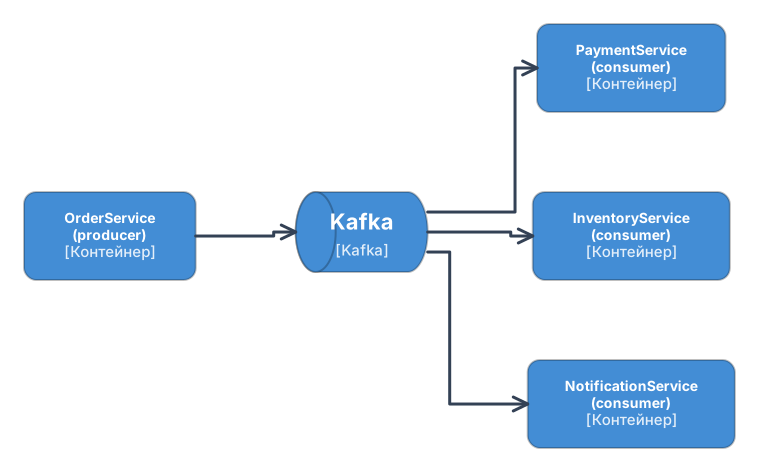
OrderService не знает, кто его читает. Новые потребители добавляются без изменений в коде отправителя.
Топик, партиция, offset
Топик
Сервисам нужно договориться, куда писать и откуда читать, не зная друг о друге. Точка встречи — топик: именованный лог сообщений, в который одни сервисы пишут, а другие из него читают. Имя отражает домен: order-events, payment-events, inventory-changes.
Каждое сообщение — пара (ключ, значение) плюс метаданные (timestamp, headers, offset):
ключ:    "order-12345"
значение: {"type":"OrderCreated","orderId":"12345","total":1500.00}
Партиция
Один лог на топик упёрся бы в один сервер и одного читателя: миллион событий в минуту через него не протолкнуть. Поэтому топик физически разбит на партиции. Партиция — это упорядоченный неизменяемый лог: сообщения только добавляются в конец, никогда не меняются и не удаляются (до истечения срока хранения).
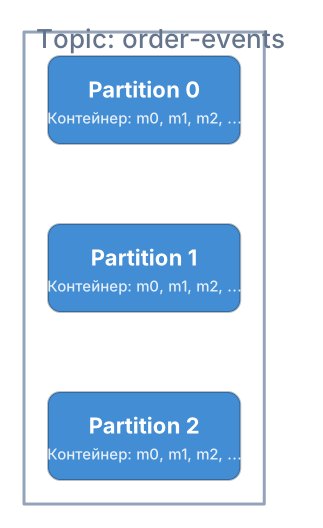
Зачем партиции:
- Параллелизм — разные потребители читают разные партиции одновременно.
- Масштабирование — партиции распределяются по разным брокерам (серверам).
- Порядок — гарантируется только внутри одной партиции.
Offset
Потребитель упал и поднялся — с какого места продолжать? Для этого каждое сообщение в партиции имеет порядковый номер — offset. Потребитель запоминает, до какого offset он дочитал, и продолжает именно оттуда. Это позволяет перечитать старые сообщения или начать с начала.
Из чего состоит кластер
Слово «Kafka» в схемах обычно нарисовано одним прямоугольником, и до первого сбоя этого хватает. Внутри же три разные роли, и знать их нужно, чтобы понимать сообщения об ошибках.
Брокер — один процесс Kafka на одном сервере. Брокеры держат данные: каждая партиция физически лежит файлами на диске конкретных брокеров. Кластер — это несколько брокеров, договорившихся между собой; минимальная отказоустойчивая установка — три.
Контроллер — роль, а не отдельный сервер: один из брокеров следит за составом кластера и распределением партиций, а при его отказе роль берёт другой. В старых версиях эту работу делал отдельный ZooKeeper, в современных (режим KRaft) всё живёт внутри самих брокеров, и ZooKeeper не нужен. Для читателя это значит, что в руководствах старше 2023 года будет лишний компонент, которого у вас нет.
Лидер партиции. У каждой партиции один брокер-лидер и несколько последователей с копиями. Вся запись и всё чтение идут через лидера — последователи только повторяют его журнал, ради отказоустойчивости. Лидеры разных партиций одного топика намеренно размещаются на разных брокерах: так нагрузка делится между машинами.
Отсюда понятно, как клиент находит, куда идти. Первым делом он обращается к любому адресу из списка bootstrap.servers — это не «главный сервер», а просто точка знакомства — и запрашивает метаданные: какие есть партиции и кто у каждой лидер. Дальше он ходит напрямую к нужным брокерам и обновляет метаданные, когда лидер меняется. Поэтому адреса брокеров должны быть доступны клиенту напрямую: типичная ошибка первого запуска в контейнерах — брокер сообщает внутреннее имя, до которого приложению снаружи не дотянуться, и клиент бесконечно повторяет попытки с жалобой на недоступный узел, хотя знакомство прошло успешно.
Отправитель и потребитель
Producer — клиент, который пишет в Kafka. Consumer — клиент, который читает из Kafka.
// Отправитель
@Service
@RequiredArgsConstructor
public class OrderEventPublisher {
    private final KafkaTemplate<String, String> kafka;

    public void publish(OrderCreatedEvent event) {
        kafka.send("order-events", event.orderId(), toJson(event));
    }
}

// Потребитель
@Component
public class PaymentListener {
    @KafkaListener(topics = "order-events", groupId = "payment-service")
    public void onOrderCreated(ConsumerRecord<String, String> record) {
        OrderCreatedEvent event = fromJson(record.value(), OrderCreatedEvent.class);
        // обработка...
    }
}
Куда попадает сообщение: роль ключа
Producer выбирает партицию по правилу:
- Ключ указан →
partition = hash(ключа) % количество_партиций. Все сообщения с одинаковым ключом всегда попадают в одну партицию. - Ключ не указан → продьюсер сам решает, куда положить. Не по кругу, как можно подумать: он набирает пачку в одну партицию, отправляет её целиком и только потом переключается на следующую. Так получается меньше сетевых запросов, а нагрузка всё равно размазывается ровно.
Это важно для порядка. Если все события одного заказа должны быть в правильном порядке — используйте orderId как ключ:
// Правильно: ключ — orderId, все события заказа в одной партиции
kafka.send("order-events", event.orderId(), payload);

// Неправильно: без ключа события разлетятся по разным партициям
kafka.send("order-events", null, payload);
Число партиций не меняют на ходу
Если увеличить количество партиций в существующем топике, формула hash(ключа) % N даст другие результаты. Часть сообщений попадёт в другую партицию — порядок нарушится. Поэтому количество партиций планируют заранее с запасом и не меняют на ходу без миграции данных.
Порядок сообщений
Внутри одной партиции порядок гарантирован — сообщения хранятся и доставляются именно в том порядке, в котором были записаны.
Между партициями порядок не определён. Если события одного заказа попали в разные партиции, они могут быть прочитаны в произвольном порядке.
Вывод: хотите упорядоченную обработку всех событий какого-то объекта — используйте его идентификатор как ключ сообщения.
Consumer Groups: как потребители делят работу
Consumer Group — это несколько потребителей с одинаковым groupId. Kafka распределяет партиции топика между ними: каждая партиция назначается ровно одному потребителю в группе.
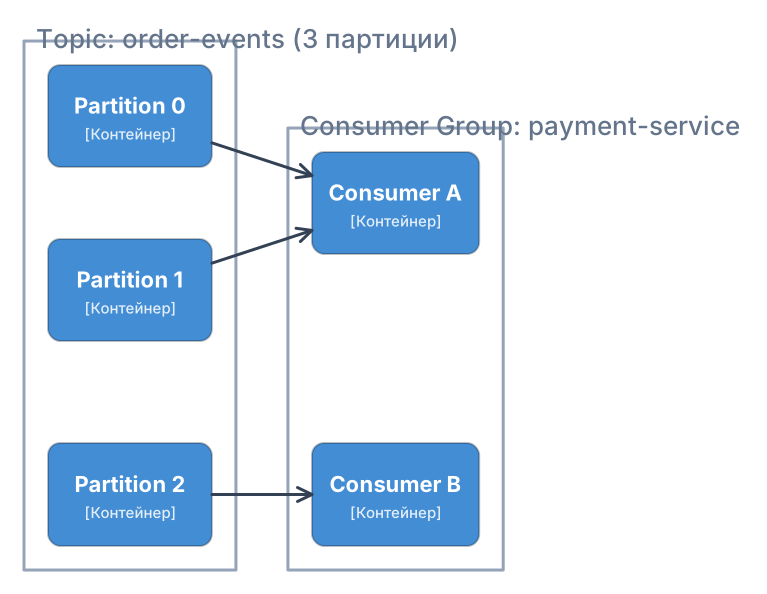
Что это даёт:
- Параллелизм ограничен числом партиций: если партиций 3, а потребителей 5 — двое будут простаивать.
- Каждое сообщение в группе обрабатывается ровно одним потребителем — нагрузка делится, а не дублируется.
- Разные группы независимы:
PaymentServiceиInventoryServiceобе читаютorder-events, но каждая со своим offset — как если бы у каждой была своя копия топика.
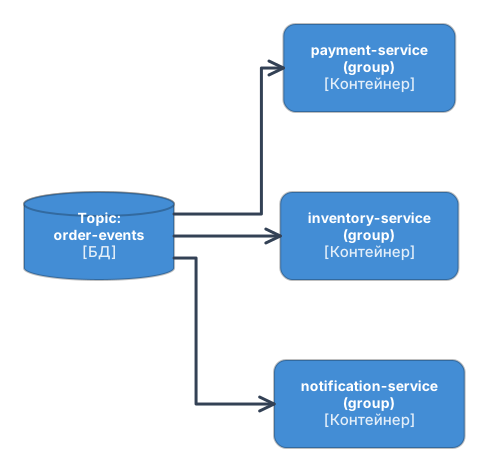
Когда потребитель падает или добавляется новый, Kafka перераспределяет партиции — это называется rebalance. На время перераспределения группа не обрабатывает сообщения. Частые rebalance замедляют работу, поэтому стараются их избегать.
Ребаланс: почему группа периодически замирает
Ребаланс назван выше одной строкой, а на практике это самая частая причина жалоб «Kafka тормозит». Стоит разобрать, когда он случается и почему бывает бесконечным.
Что его вызывает. Потребитель присоединился или ушёл, потребитель перестал отвечать, у топика изменилось число партиций. Первый случай штатный, а второй — самый частый и самый неприятный: группа считает потребителя мёртвым, хотя процесс жив.
Живость проверяется двумя разными таймерами, и путать их не надо. session.timeout.ms (по умолчанию 45 секунд) — про сердцебиение: клиент отправляет служебные сигналы фоновым потоком, и если их нет столько времени, потребителя исключают. max.poll.interval.ms (по умолчанию 5 минут) — про обработку: если между двумя вызовами poll() прошло больше, группа считает, что потребитель завис, и забирает у него партиции. Второй и срабатывает в реальной жизни: пачка из пятисот сообщений, каждое по секунде — и вы вышли за пять минут, не сделав ничего плохого. Лечится это уменьшением max.poll.records (сколько сообщений отдаётся за один poll), а не увеличением таймаута до часа: большой таймаут означает, что настоящий зависший потребитель будет держать партиции час.
Два протокола распределения. Старый, eager: все потребители отпускают все партиции, потом получают новые назначения — на это время группа стоит целиком, и это то самое «замирание». Новый, cooperative-sticky: партиции переназначаются по частям, каждый потребитель отпускает только то, что действительно уходит другому, и остальные продолжают работать. В современных клиентах он и стоит по умолчанию (partition.assignment.strategy), а в старых его включают руками — это одна из самых дешёвых настроек, улучшающих поведение под нагрузкой.
Статическое членство группы. Отдельная беда — выкат: перезапустили три экземпляра по очереди, получили три ребаланса. Лечится настройкой group.instance.id: каждый экземпляр получает постоянное имя, и его короткий перезапуск (в пределах session.timeout.ms) не вызывает перераспределения — партиции ждут его возвращения. Для выкатов в Kubernetes, где имя пода стабильно у StatefulSet, это работает особенно удобно.
Признак, по которому ребаланс видно в журнале: строки про присоединение к группе и про отозванные партиции, повторяющиеся каждые несколько минут. Если они идут по кругу, ищите долгую обработку, а не проблемы сети.
Commit offset: отметка о прогрессе
Потребитель сообщает Kafka, какие сообщения обработал — это называется commit offset. Без этого после перезапуска Kafka не знала бы, откуда продолжать.
Автоматический commit — режим «голого» клиента Kafka (enable.auto.commit=true). Работает он не по фоновому таймеру, как можно подумать, а внутри poll(): на каждом вызове клиент смотрит, прошло ли с прошлой фиксации auto.commit.interval.ms (по умолчанию 5 секунд), и если прошло — фиксирует всё, что успел отдать приложению. Удобно, но опасно: сообщения отданы, offset сдвинут, а обработаны они или нет — клиент не знает. Упали в этот момент — потеряли.
Если вы пишете на Spring Kafka, «по умолчанию» означает противоположное. Spring сам выставляет enable.auto.commit=false и фиксирует offset за вас — после того, как обработана вся пачка, выданная одним poll (режим AckMode.BATCH). Это уже не «раз в 5 секунд вслепую», но и не «после каждого сообщения».
Ручной commit — надёжнее. Только объект Acknowledgment прилетит в метод не сам по себе: контейнеру надо явно сказать, что подтверждает приложение, иначе параметр будет null и первый же ack.acknowledge() уронит обработчик.
spring:
  kafka:
    listener:
      ack-mode: manual   # без этой строки Acknowledgment в методе будет null
@KafkaListener(topics = "order-events", groupId = "payment-service")
public void onMessage(ConsumerRecord<String, String> record, Acknowledgment ack) {
    processEvent(record);
    ack.acknowledge(); // фиксируем только после успешной обработки
}
Try/catch здесь не нужен: если processEvent бросит исключение, до ack.acknowledge() дело не дойдёт, offset не сдвинется, и сообщение придёт снова.
auto.offset.reset: почему новый потребитель не видит старых сообщений
Первый вопрос, который задаёт каждый, кто только запустил потребителя: в топике лежат сообщения, потребитель подключился — и тишина. Дело не в сбое. Смещения у новой группы ещё нет, и потребитель должен решить, откуда читать; решает он это настройкой auto.offset.reset, и по умолчанию она равна latest — то есть «читать только то, что придёт дальше».
Значений два. latest начинает с конца: старое не читается вовсе. earliest начинает с самого начала топика: прочитано будет всё, что ещё не удалено по сроку хранения.
spring:
  kafka:
    consumer:
      auto-offset-reset: earliest
Работает эта настройка только когда смещения нет — у новой группы или когда сохранённое смещение уже вне доступного диапазона, потому что данные удалились по сроку хранения. Для группы, которая уже читала, она ничего не меняет: смещение есть, и потребитель продолжит с него. Отсюда типичная путаница: поставили earliest, перезапустили — и снова ничего, потому что группа та же и смещение сохранено. Чтобы перечитать заново, меняют имя группы или сдвигают смещение отдельной командой (kafka-consumer-groups --reset-offsets).
Выбор значения — это не вкус, а решение о смысле. Для аналитики и построения состояния из истории нужен earliest: пропустить события нельзя. Для обработки команд «здесь и сейчас» разумнее latest: после недельного простоя не нужно заваливать сервис недельным потоком. А вот earliest у второго случая даёт неприятный сюрприз в проде: сервис, поднятый с новой группой, начнёт заново обрабатывать всё, что хранится, и разошлёт письма за месяц.
С ручным commit'ом потребитель может получить одно сообщение дважды (при перезапуске после сбоя). Это называют at-least-once — и это стандартный подход. Цена: потребитель должен уметь обрабатывать одно и то же сообщение несколько раз без побочных эффектов (быть идемпотентным).
Заголовки и формат события
Сообщение в Kafka — это не только ключ и тело. У него есть заголовки: набор пар «имя — байты», как в HTTP. Тело при этом остаётся данными события, а всё служебное едет в заголовках.
var record = new ProducerRecord<>("order-events", order.id(), payload);
record.headers()
        .add("event-type", "OrderCreated".getBytes(UTF_8))
        .add("event-version", "2".getBytes(UTF_8))
        .add("traceparent", traceId.getBytes(UTF_8));
Что обычно кладут туда: тип события (когда в одном топике едут разные типы), версию схемы, идентификатор трассировки для сквозного просмотра запроса, идентификатор для проверки повторов. Что туда не кладут: персональные данные — заголовки видны всем читателям топика и попадают в журналы инструментов так же легко, как и тело.
Отдельный вопрос — формат тела и его развитие. Событие живёт дольше кода, который его написал: в топике с недельным сроком хранения читатель встретит и сегодняшнюю версию, и ту, что была пять дней назад, а если топик сжатый по ключу — то и годовалую. Значит, менять формат можно только совместимо: добавлять необязательные поля, не переименовывать существующие, не сужать типы. Удаление поля делают в два шага: сначала читатели перестают его требовать, потом отправитель перестаёт его писать.
Дисциплины на это две. Проще — договорённость в команде плюс терпимый разбор JSON: неизвестные поля игнорируются, отсутствующие имеют значения по умолчанию. Строже — реестр схем (Schema Registry) с Avro или Protobuf, который сам отвергает несовместимое изменение при отправке; за это платят ещё одним сервисом в контуре. Выбор между ними — тот же разговор про цену эксплуатации, что и с самой Kafka; подробный разбор совместимости событий — в статье про шаблоны обмена сообщениями.
Гарантии доставки
Дубли и потери берутся с двух сторон. Отправитель не получил подтверждение и повторил отправку, хотя первая доехала, — дубль. Потребитель отметил прогресс раньше, чем обработал, и упал, — потеря; отметил позже и упал — дубль. Из того, что с этим делают, складываются три режима:
| Режим | Смысл | Применение |
|---|---|---|
| At-most-once | Доставлено или потеряно — без дублей | Метрики, логи, телеметрия |
| At-least-once | Доставлено хотя бы один раз, возможны дубли | Большинство бизнес-сценариев |
| Exactly-once | Ровно один раз, без потерь и дублей | Финансовые операции, критичные к дублям |
At-least-once + идемпотентный потребитель — стандартный выбор для бизнес-событий. Exactly-once технически реализуемо (transactional producer + read-committed consumer), но сложнее и медленнее.
Idempotent Producer
Producer может отправить сообщение дважды, если подтверждение не дошло: ответа нет, он повторяет отправку — а первая попытка на самом деле доехала. От этого защищает enable.idempotence=true: Kafka присваивает сообщениям порядковые номера и отбрасывает повторы. Начиная с Kafka 3.0 и эта настройка, и acks=all — значения по умолчанию, так что задача не «включить», а «не сломать»: выставленный вручную acks=1 «для скорости» заодно молча отключит и защиту от дублей.
spring:
  kafka:
    producer:
      properties:
        enable.idempotence: true   # с Kafka 3.0 это уже значение по умолчанию
        acks: all                  # и это тоже — здесь выписано явно, чтобы не потерять
        retries: 2147483647
Это защищает от дублей при повторных попытках отправки. Но если сам сервис перезапустился и отправляет сообщение заново — это уже другое сообщение с точки зрения Kafka. Поэтому потребители всё равно должны быть идемпотентными.
Атомарность: запись в базу и отправка события
Распространённая задача: нужно сохранить заказ в базе данных и одновременно отправить событие в Kafka. Если сначала сохранить, а потом отправить — при сбое между этими шагами событие будет потеряно.
Решение — Transactional Outbox: событие записывается в ту же транзакцию базы данных, что и сам заказ. Отдельный фоновый процесс читает необработанные записи и отправляет их в Kafka.
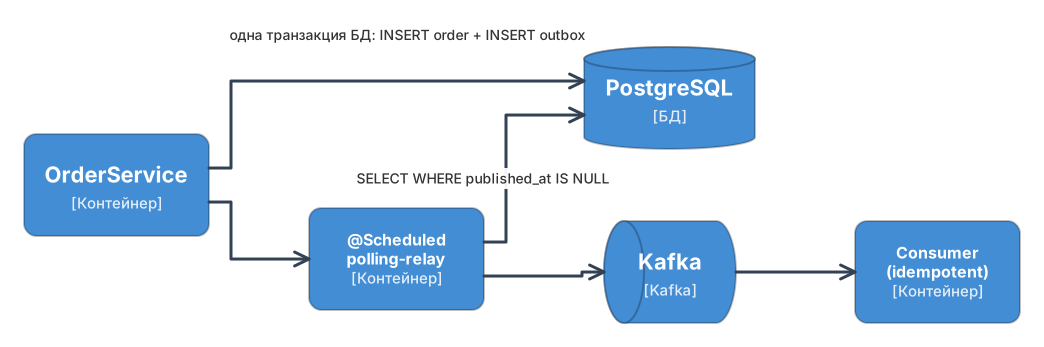
Ничего не теряется (запись атомарна), ничего лишнего не отправляется (relay видит только завершённые записи). Подробнее этот паттерн разобран в статье «Распределённые паттерны».
Репликация: что если сервер упадёт
Каждая партиция хранится не на одном сервере, а на нескольких. Один из них — лидер, остальные — реплики. Записи всегда идут к лидеру; читают обычно тоже с него, но потребителя можно настроить и на чтение с ближайшей реплики — это экономит трафик между зонами доступности, ценой небольшого отставания данных. Реплики догоняют лидера и формируют ISR (In-Sync Replicas — синхронизированные реплики). Синхронной считается та, что отстала от лидера не больше чем на replica.lag.time.max.ms — по умолчанию 30 секунд; отстала сильнее — брокер выбрасывает её из ISR, догнала — возвращает обратно. Если лидер падает, новым становится одна из реплик, оставшихся в ISR.
Producer указывает, насколько строгое подтверждение ему нужно (acks):
acks | Что значит | Риск |
|---|---|---|
0 | Отправил и забыл | Можно потерять |
1 | Лидер получил | Потеря при падении лидера до репликации |
all | Все синхронизированные реплики получили | Надёжно |
Для бизнес-событий — acks=all. Одного этого мало: настройка означает «дождись подтверждения от всех реплик, которые сейчас считаются синхронными», а если такая реплика осталась одна, то и подтверждение придёт от неё одной — и вместе с ней данные пропадут. Поэтому в паре с ней на топике задают min.insync.replicas=2: тогда при нехватке живых реплик запись честно завершится ошибкой, а не примет данные, которые некому сохранить.
Верхний ряд: при acks=all подтверждение приходит от единственной синхронной реплики и уходит вместе с ней; нижний: min.insync.replicas=2 отклоняет такую запись сразу.
Срок хранения сообщений
Kafka — это лог, и у него есть настраиваемый срок хранения:
- По времени (
retention.ms) — например, 7 дней. - По размеру (
retention.bytes) — например, 1 ТБ на партицию. - Компакция (
cleanup.policy=compact) — хранится только последнее сообщение для каждого ключа. Подходит для хранения текущего состояния: остатков на складе, актуальных цен, профилей пользователей. Удалить ключ из такого топика можно единственным способом — записать по нему сообщение со значениемnull. Его называют надгробием (tombstone): компакция сначала оставит его как последнее значение ключа, а спустя настроенное время уберёт и его. Без надгробий из compact-топика не исчезает ничего.
Это настройки самого топика, а не приложения: в application.yml их класть бесполезно, Kafka туда не смотрит. Задают их при создании топика или меняют у существующего:
# топик с компакцией — актуальные остатки
kafka-topics.sh --create --topic inventory-current \
  --bootstrap-server localhost:9092 \
  --config cleanup.policy=compact

# обычный топик событий — хранить 7 дней
kafka-topics.sh --create --topic order-events \
  --bootstrap-server localhost:9092 \
  --config cleanup.policy=delete --config retention.ms=604800000

# поменять срок хранения у уже существующего топика
kafka-configs.sh --alter --topic order-events \
  --bootstrap-server localhost:9092 \
  --add-config retention.ms=259200000
Когда Kafka не нужна
Kafka хорошо работает для потоков событий с высокой нагрузкой. Но она не для всего:
- Нужен ответ на запрос — Kafka однонаправленная, запрос-ответ через неё громоздко. Лучше HTTP.
- Мало событий — Kafka оптимизирована для высокой нагрузки; для нескольких событий в день это избыточно.
- Нужна сложная маршрутизация по правилам — RabbitMQ с routing-правилами подойдёт лучше.
Список без замены бесполезен, поэтому вот чем заменяют, по случаям.
Фоновые задачи одного сервиса (отправить письмо, собрать отчёт, пересчитать кэш) — таблица заданий в той же базе, которую сервис и так использует: строка со статусом, выборка через SELECT ... FOR UPDATE SKIP LOCKED, повторы счётчиком попыток. Ни брокера, ни нового навыка эксплуатации, а транзакция общая с бизнес-данными. Это выбор по умолчанию для небольших сервисов, и его недооценивают.
Адресные команды с приоритетами, задержками и отдельным подтверждением каждой — RabbitMQ. Он же нужен, когда маршрутизация правда сложная и когда важно, чтобы неудавшаяся задача вернулась другому исполнителю, а не перечитывалась заново. Подробное сравнение — в статье про выбор между ними.
Запрос с ответом — обычный HTTP или gRPC. Если смущает связанность, её лечат не брокером, а таймаутами, повторами и предохранителем; асинхронность ради асинхронности превращает простой вызов в распределённую отладку.
Оповещение браузера или мобильного приложения — WebSocket или отправка уведомлений через платформу, а не Kafka: клиенту не нужен журнал событий, ему нужно одно сообщение сейчас.
Kafka остаётся правильным ответом, когда поток событий читают несколько независимых потребителей, когда историю нужно перечитывать и когда счёт идёт на десятки тысяч сообщений в секунду.
Глубже: сколько партиций и потребителей: расчёт, а не число с потолкарасширенное
«Число партиций не меняют на ходу» превращает выбор в решение, которое живёт годами, а в статьях число берётся с потолка. Считают его от четырёх величин, и все четыре измеряют, а не угадывают.
Пропускная способность одного потребителя, C: сколько записей в секунду обрабатывает один экземпляр слушателя с настоящим обработчиком (запись в базу, вызов сервиса), измеряется на стенде. Целевой поток, T: пиковый, а не средний, с запасом на рост за срок жизни топика, обычно вдвое. Отсюда нижняя граница числа потребителей, T / C, а партиций не меньше, чем потребителей, иначе лишние стоят. Третья величина, целевое время разгребания: если после часового простоя потребителей накопилось B записей, а разгрести нужно за время R, потребителей нужно (B / R + T) / C, и это обычно больше, чем от потока. Четвёртая, поток одного продьюсера на партицию: лидер партиции принимает десятки мегабайт в секунду, и для потока в сотни мегабайт партиций нужно больше по этой причине, а не по потребителям.
Пример: обработчик тянет 200 записей в секунду, пик 1 000, час простоя даёт 3,6 миллиона записей, разгрести за полчаса: (3 600 000 / 1 800 + 1 000) / 200 = 15 потребителей, партиций 16 или 24 с запасом. Правило округления вверх до числа, которое делится на разумные размеры групп (6, 12, 24), чтобы партиции распределялись между потребителями поровну.
Что ограничивает сверху. Каждая партиция это открытые файлы и память на брокере, участие в репликации и выборах лидера; тысячи партиций на брокер замедляют восстановление после отказа, и планировщик кластера смотрит на общее число, а не на один топик. Партиций больше сотни в топике нужно редко, и это повод спросить, не надо ли разделить топик. И ключ: партиций по ключу тем больше, чем неравномернее ключи, потому что горячий клиент займёт одну партицию целиком, и никакое число потребителей это не ускорит; о том, что делать с горячим ключом, говорит статья про секционирование.
У RabbitMQ расчёт проще: очереди дёшевы, потребители масштабируются без потолка, и считают только T / C с запасом на пик, а надёжных очередей заводят десятки, не тысячи, потому что каждая это своя группа согласования.
Глубже: второй кластер и второй регион: MirrorMaker 2расширенное
Репликация выше это копии партиций внутри одного кластера, и она защищает от падения брокера, но не от падения зоны или региона целиком, и не помогает, когда потребители живут в другом дата-центре и хотят читать локально. Растягивать кластер на регионы нельзя: задержка между ними ломает репликацию и выборы лидера. Между кластерами данные возят отдельным инструментом, и штатный это MirrorMaker 2.
Он работает как набор коннекторов Kafka Connect: читает топики из кластера-источника и пишет в кластер-приёмник, по умолчанию с префиксом имени источника (msk.orders вместо orders), чтобы при двусторонней репликации топики не зациклились; политику имён можно поменять на тождественную для активно-пассивной схемы. Порядок внутри партиции сохраняется, дубли возможны, потому что доставка между кластерами «хотя бы раз», и потребители на приёмнике должны быть идемпотентны так же, как в исходном кластере.
Главная сложность не в данных, а в оффсетах: у приёмника они свои, и группа потребителей, переехавшая на второй кластер, не знает, докуда дочитала на первом. MirrorMaker 2 ведёт служебный топик контрольных точек и переводит оффсеты групп между кластерами (с версии 2.7 может синхронизировать их сам), так что после переключения группа продолжает с примерно того же места, с повторами вместо потерь. Отставание репликации между кластерами это и есть потеря при аварии, RPO, и его выносят на график.
Две схемы. Активно-пассивная: пишут в один кластер, второй получает копию и ждёт; переключение это смена адресов у продьюсеров и потребителей плюс перевод оффсетов, и его репетируют заранее, потому что вручную под давлением оно не получается. Активно-активная: каждый регион пишет в свой кластер, а читает и свои, и зеркальные топики соседа, объединяя их в приложении; дубли и порядок между регионами решает сама бизнес-логика, и это на порядок сложнее. У облачных и коммерческих дистрибутивов есть свои средства связи кластеров без префиксов и с сохранением оффсетов, но идея та же: асинхронная копия с отставанием и переключение как процедура. У RabbitMQ роль MirrorMaker играют Federation и Shovel, о чём статья про RabbitMQ в production.
Коротко
- Топик — именованный лог событий. Партиция — его физическая часть, упорядоченная и неизменяемая. Ключ сообщения определяет партицию: один ключ → одна партиция → порядок гарантирован.
- Offset — позиция потребителя. Commit offset после обработки, не до. Consumer Group делит партиции между потребителями. Несколько групп читают один топик независимо.
- Стандартный выбор: at-least-once + ручной commit + идемпотентный потребитель. Для атомарности «база + Kafka» — паттерн Transactional Outbox.
- Репликация защищает от потери данных при падении сервера. Для надёжности —
acks=allвместе сmin.insync.replicas=2. Срок хранения настраивается по времени или размеру; компакция хранит только последнюю версию для каждого ключа. - Партиции считают от измеренного:
(накопленное / время разгребания + пиковый поток) / поток одного потребителя, с запасом и кратно размеру группы; сверху ограничивают файлы и восстановление брокера, а горячий ключ не лечится числом партиций. - Между кластерами и регионами данные возит MirrorMaker 2: асинхронно, с префиксом топиков, «хотя бы раз», с переводом оффсетов групп; отставание это RPO, переключение репетируют.
- Внутри кластера три роли: брокеры хранят партиции, один из них контроллер (в режиме KRaft, без ZooKeeper), а запись и чтение идут через лидера партиции;
bootstrap.servers— только точка знакомства, дальше клиент ходит к брокерам напрямую. - Новая группа по умолчанию читает только новое (
auto.offset.reset: latest), аearliestдействует лишь когда смещения нет — перечитать заново можно сменой группы или сбросом смещений. - Ребаланс чаще всего вызывает долгая обработка (
max.poll.interval.ms), лечится он меньшимmax.poll.records, протоколомcooperative-stickyи статическим членством черезgroup.instance.id. - Служебное едет в заголовках (тип, версия, трассировка), а формат тела меняют только совместимо: новые поля необязательные, удаление в два шага, дисциплину держит реестр схем или терпимый разбор.
Что пощупать
Ключ, заголовки, порядок и атомарность записи с отправкой в практикуме remodov/marketplace-system собраны в одном коротком классе: сервис заказов публикует события из таблицы исходящих в один топик, ключом ставит идентификатор заказа, а метаданные события кладёт в заголовки. Kafka поднимается из infra/compose.yaml.
Код: adapter-out-kafka, контракт.
Сделаем сами
Ветка step-10-events-and-contract — публикация в outbox и правила сериализации вынуты, три теста красные.
Что почитать дальше
- Kafka в production — Spring Kafka, Dead Letter Queue, Schema Registry, consumer lag, настройка производительности, безопасность, KRaft.
- Распределённые паттерны — Outbox + polling-relay, Saga, Idempotent Consumer подробно.
- CQRS — Kafka как канал между командной и читающей моделью.